Guides
書き方ガイド
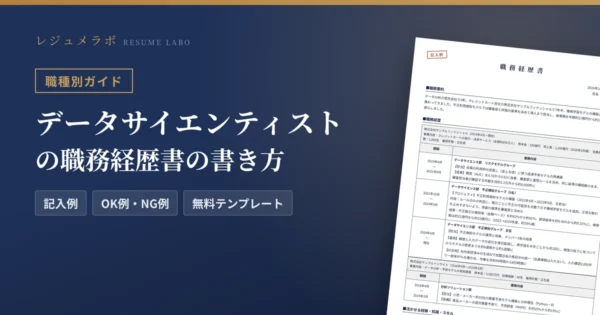
データサイエンティストの職務経歴書でよくあるのが、「LightGBMで特徴量エンジニアリングを行い、AUC0.95を達成しました」という書き方です。技術の力は伝わりそうに見えますが、そのモデルが何の役に立ち、事業の何が変わったのかはわかりません。採用担当が知りたいのは、どんな課題にモデルを作り、どんな基準で評価し、事業の数字がどう動いたかです。
データサイエンティストの仕事は、モデルを作ることだけではありません。業務の担当者と目標を決め、精度を確かめ、本番の業務に組み込み、データが変わっても使い続けられるように運用します。書類では、この流れのどこを、どこまで担ってきたかを伝える必要があります。
この記事では、データ分析の受託会社で3年、クレジットカード会社で7年半、不正利用検知などの機械学習モデルを作り、運用してきた人の記入例をもとに、項目ごとの書き方と評価される理由を解説します。経歴別の書き分け方と、AIの経験の書き方も詳しく紹介します。
この記事でわかること
無料テンプレート
データサイエンティストの職務経歴書、記入見本つきのテンプレートがあります
この記事の記入例と同じ形式で、Word・Excel・PDFの3形式。空欄のテンプレートと記入見本がセットになっています。
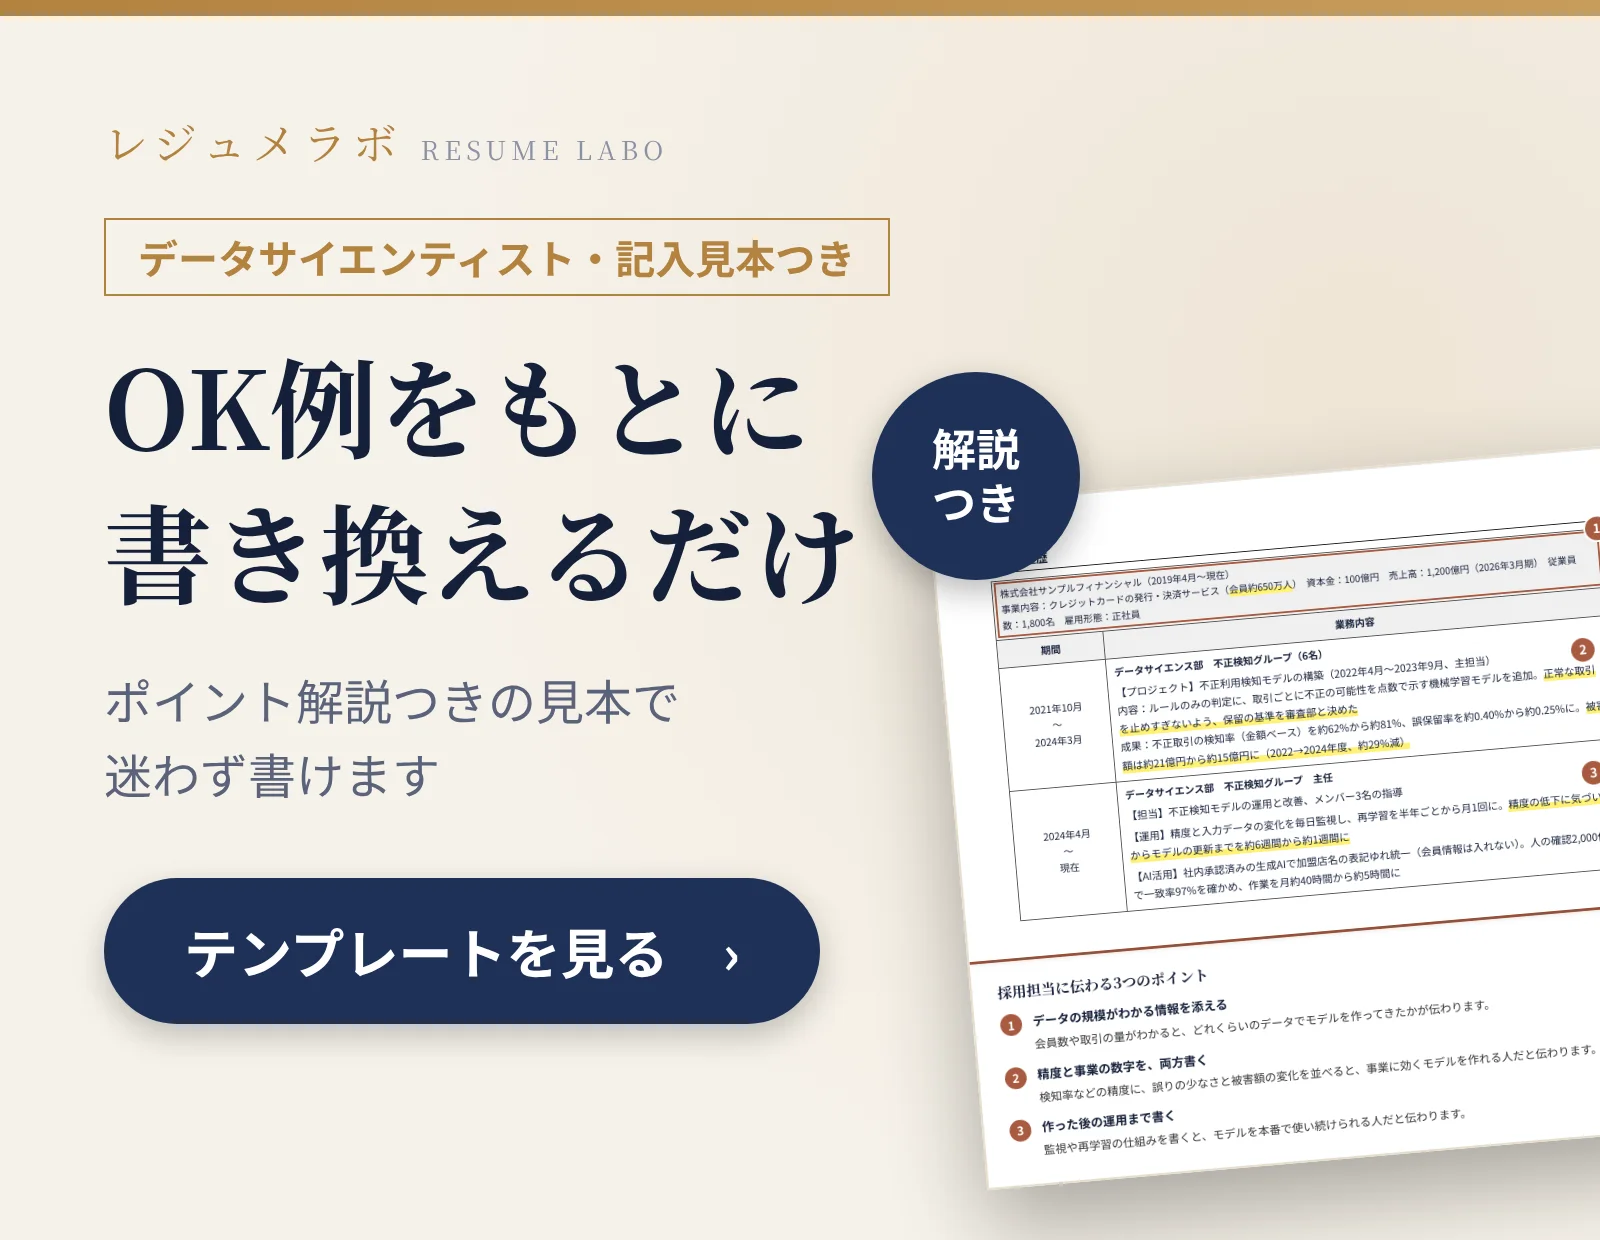
まずは完成イメージです。データ分析の受託会社で需要予測のモデルを3年作ったのち、クレジットカード会社に移って7年半。延滞予測、不正利用検知のモデルを作って導入し、現在は主任としてモデルの監視と再学習の仕組みを担っている人を想定しています。画像をタップすると拡大できます。
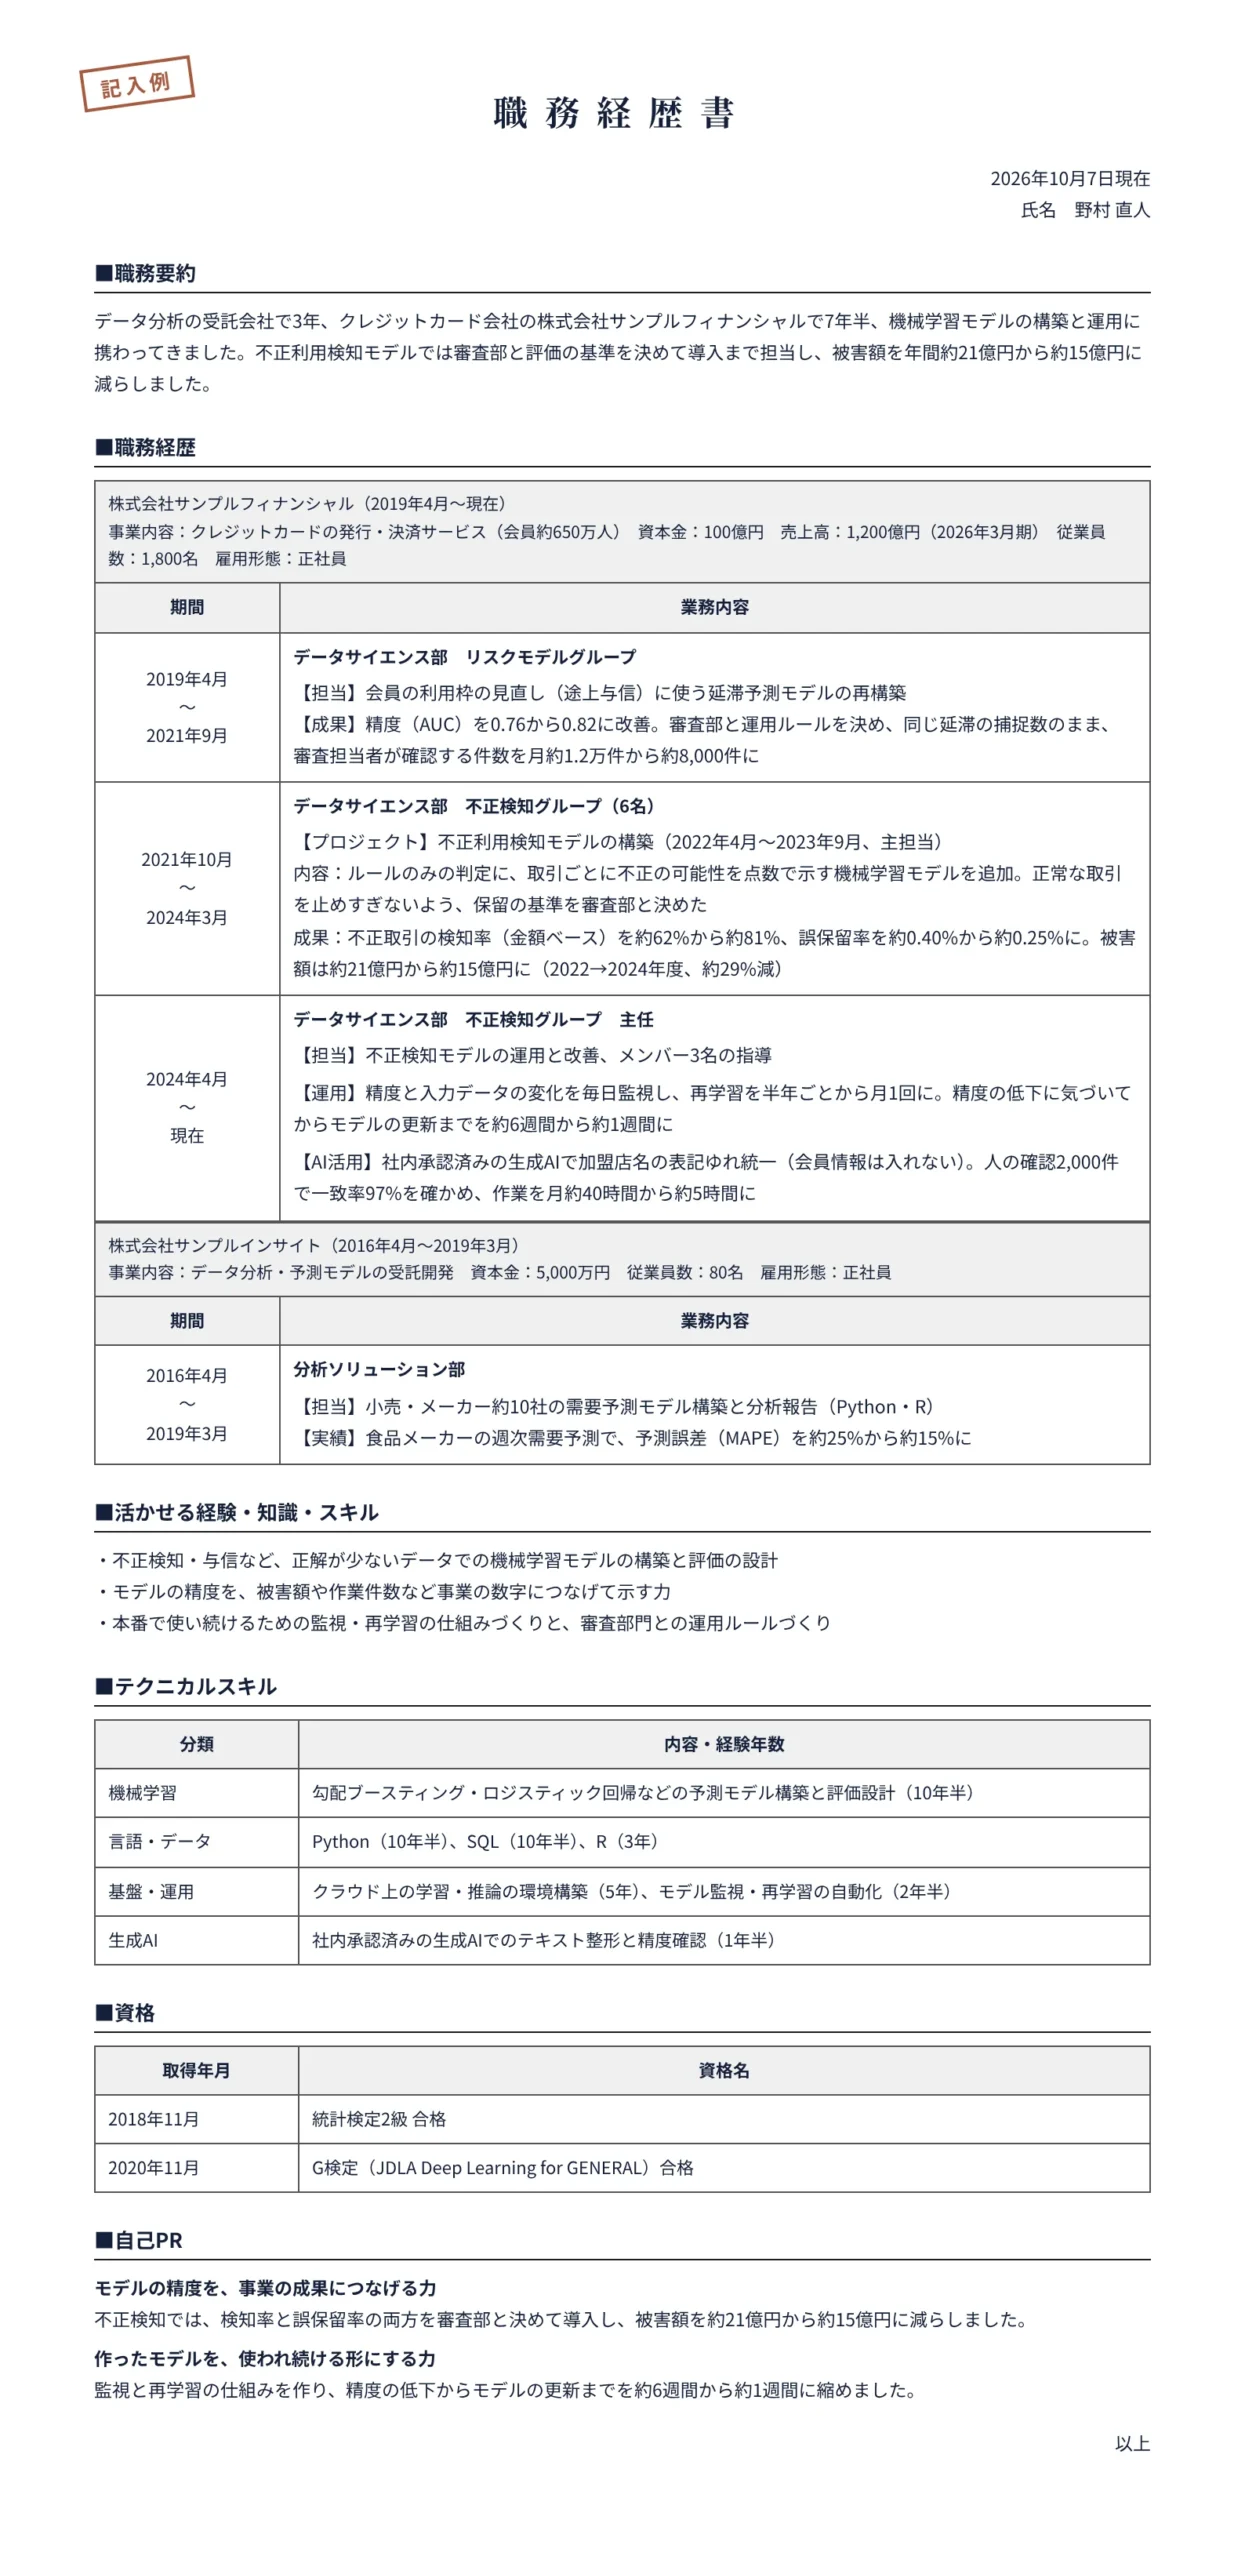
この記入例と同じ形式のテンプレートを無料で用意しています。Word・Excel・PDFの3形式で、空欄テンプレートと記入見本の2点セットです。
記入例をもとに、あなたの経歴でデータサイエンティストの職務経歴書を作る(AI職務経歴書メーカー・無料)
ツールで聞かれる質問や記入見本は、データサイエンティストの職務経歴書をAIで作成するページで先に確かめられます。
書き方に入る前に、データサイエンティストの仕事と、記入例の人物が向き合ってきた不正利用の状況を、公表されているデータで見ておきます。3つの資料を重ねると、見えてくることは1つです。データサイエンティストの仕事の中心は、モデルが本当に効くかを確かめることです。そして効果は、金額だけでなく、比べる条件をそろえた数字で語ると正しく伝わります。
厚生労働省の職業情報提供サイトjob tag「データサイエンティスト」は、この職業の主な仕事(タスク)と、それを実際に行っている人の割合を公表しています。「モデリング作業を行う」が91.1%であるのと並んで、「そのモデルが適切かどうか判断するための効果検証を行う」「モデルが新たなデータに対しても有効かどうか判断する」も91.1%でした。
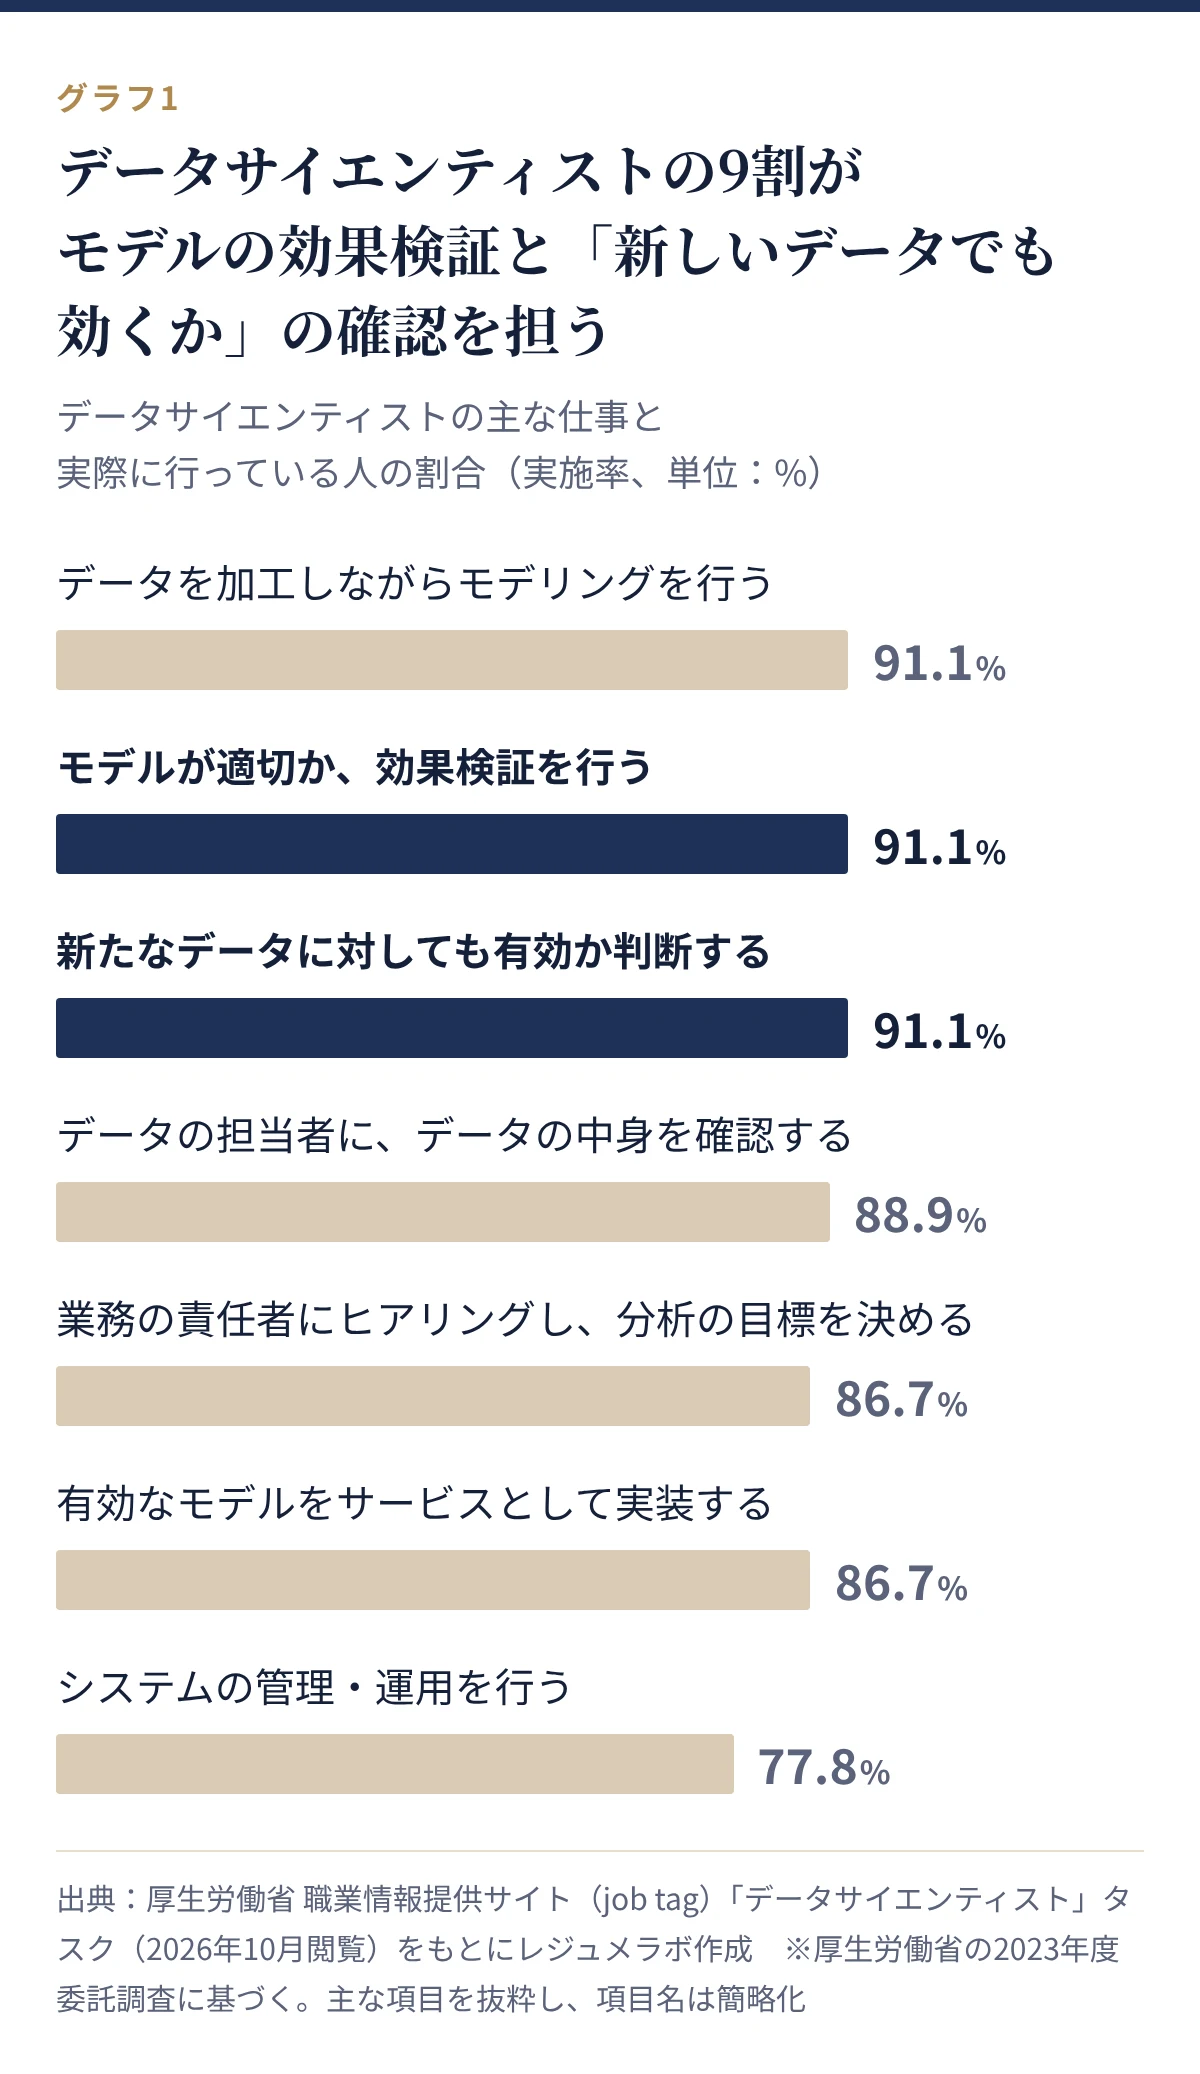
出典:job tag「データサイエンティスト」(厚生労働省) タスク
業務の責任者にヒアリングして分析の目標を決める仕事が86.7%、有効なモデルをサービスとして実装する仕事も86.7%でした。モデルを作る前の「目標を決める」と、作った後の「確かめる・組み込む」が、作る仕事と同じくらいの割合で行われています。
編集部の読みでは、職務経歴書でも、モデルの作り方より「何を目標にし、どう確かめ、どう業務に組み込んだか」に字数を使うと、仕事の実態に合った書類になります。記入例の不正利用検知モデルでも、手法の名前は書かず、「保留の基準を審査部と決めた」「検知率と誤保留率」を書いています。
次に、記入例の人物が取り組んできた不正利用の状況です。日本クレジット協会の「クレジットカード不正利用被害の集計結果について」によると、不正利用の被害額は2019年の274.1億円から、2024年には555.0億円に増えました。2025年は前年から8.0%減って510.5億円です。2025年の被害額のうち93.1%(475.4億円)は、カード番号などを盗まれて使われる「番号盗用」でした。
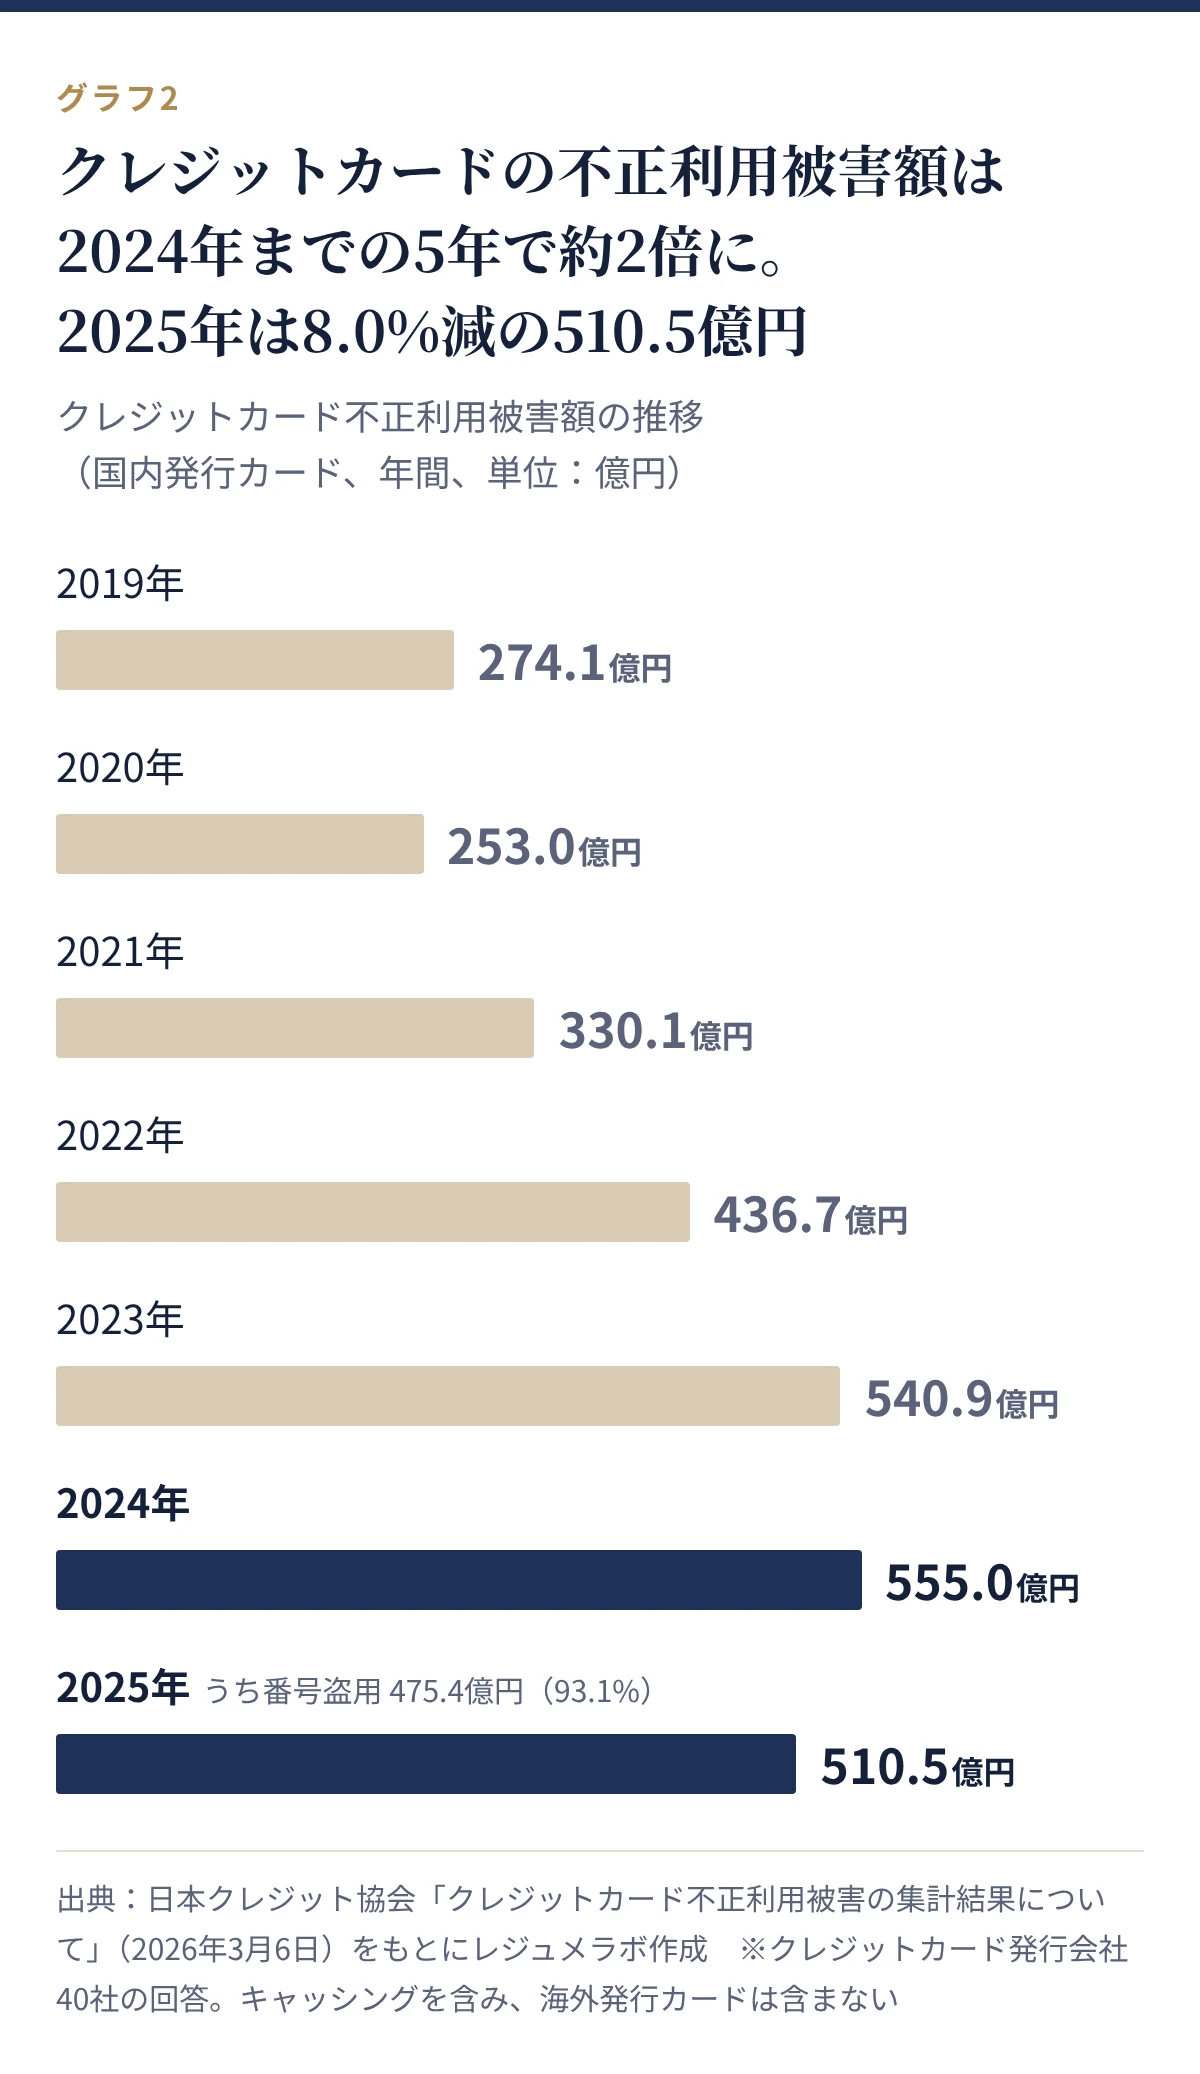
出典:クレジットカード不正利用被害の集計結果について(日本クレジット協会)
この数字は、カード会社にとって不正の検知が大きな課題であり続けていることを示しています。同時に、正常な取引まで止めてしまえば、利用者の不便や売上の機会の損失につながります。不正を見逃さないことと、正常な取引を止めすぎないことの両方が求められる分野です。
記入例で、不正取引の検知率(約62%→約81%)と、正常取引の誤保留率(約0.40%→約0.25%)を並べて書いているのはこのためです。見逃しと誤りの両方の数字を書くと、精度の高さだけを追ったのではなく、業務への影響まで考えてモデルを作ったことが伝わります。
同じ協会は、被害額をクレジットカードのショッピング利用額(信用供与額)で割った「不正利用発生率」も公表しています。2023年の0.051%をピークに、2024年は0.047%、2025年は0.038%に下がりました。2025年の利用額は134兆5,861億円で、2019年の73兆4,311億円から大きく増えています。
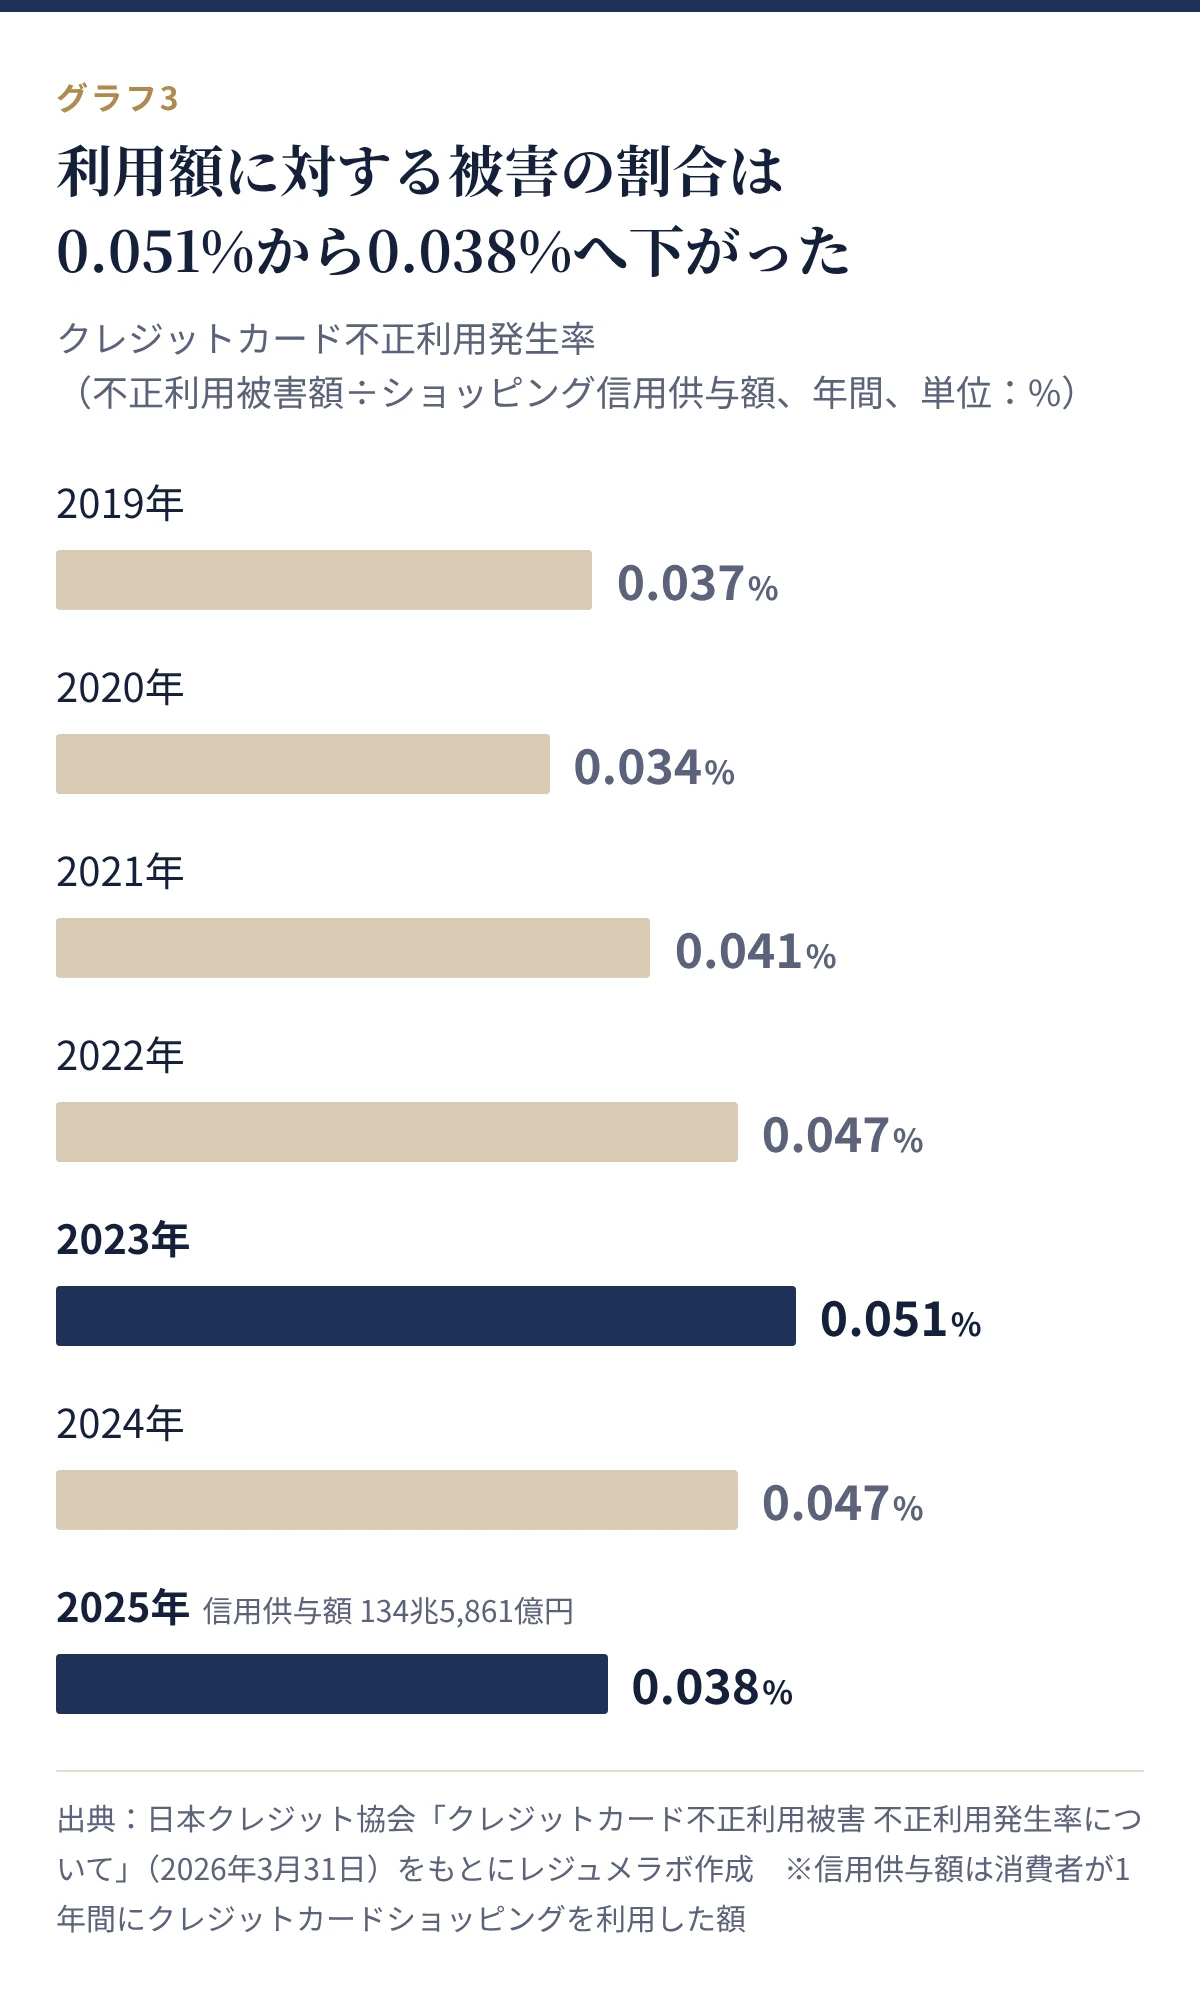
出典:クレジットカード不正利用被害 不正利用発生率について(日本クレジット協会)
被害額だけを見ると2024年が最も大きくなりますが、利用額に対する割合で見ると、2023年がピークです。同じ現象でも、何で割るか、何と比べるかで、見え方は変わります。
データサイエンティストの側から読み直すと、これは自分の成果を書くときにもそのまま当てはまります。記入例の「被害額は約21億円から約15億円に(2022→2024年度、約29%減)」は金額で書いていますが、もし同じ期間に利用額が大きく伸びていたなら、「利用額に対する被害の割合」も添えると、効果がより正確に伝わります。比べた期間・条件・割り算の分母を書くことが、データを扱う人としての信頼につながります。
まとめると、いまのデータサイエンティストの職務経歴書では、手法や精度の数字に加えて、何を目標にし、どんな条件で効果を確かめ、それが事業の数字にどうつながったかを書けるかで差がつきます。次は、採用担当が書類のどこを見ているかを確認します。
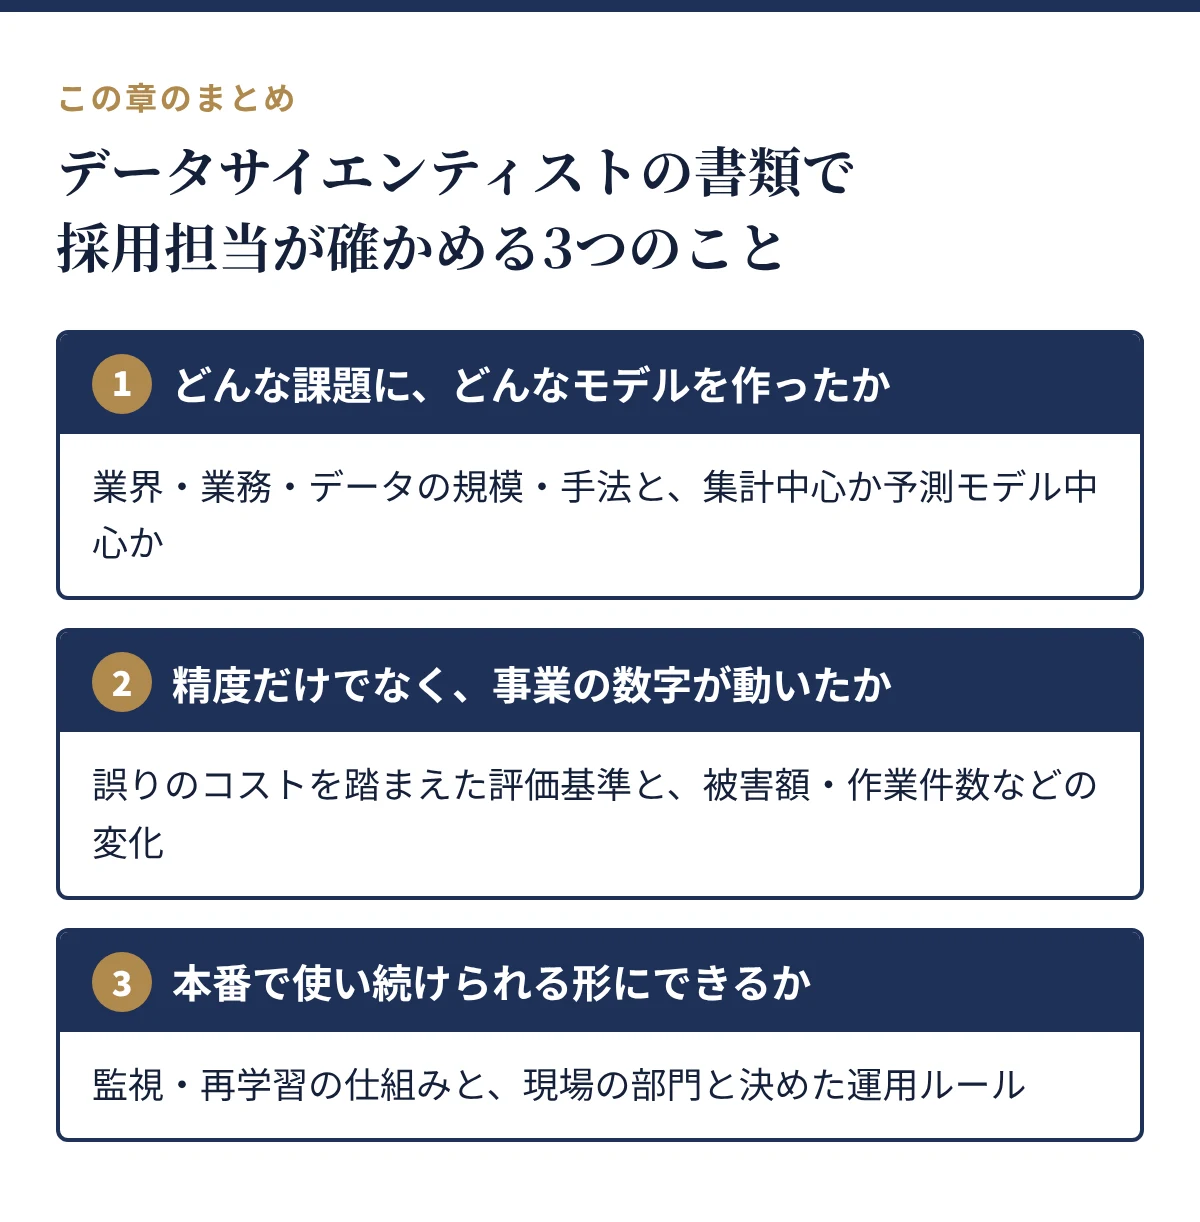
こうした変化と採用の現場でよく見られる傾向を踏まえると、データサイエンティストの採用担当は、書類から次の3つを確認しています。
3つとも、答えになるのは手法の新しさではなく、課題と評価と事業の数字のつながりです。書類を最初に読むのは、データサイエンスの専門家でない人事担当者であることも多くあります。専門用語には意味を添え、何が変わったかを誰にでもわかる形で書きましょう。
ここからは項目ごとに、NG例とOK例を並べて解説します。OK例は記入例からの引用です。データサイエンティストで特に差がつくのは、職務経歴でのモデルの書き方と、評価と事業への効果の示し方です。
職務要約は、採用担当が最初に読む部分です。経験年数に加えて、業界・扱ってきた課題・担当範囲・事業への効果を入れます。「データ分析」とだけ書くと、集計や可視化の仕事と区別がつきません。
× NG例
データサイエンティストとして約10年、機械学習を用いたさまざまなデータ分析に携わってきました。PythonやSQLを活用し、ビジネス課題の解決に貢献してきました。
ここが惜しい
○ OK例
データ分析の受託会社で3年、クレジットカード会社の株式会社サンプルフィナンシャルで7年半、機械学習モデルの構築と運用に携わってきました。不正利用検知モデルでは審査部と評価の基準を決めて導入まで担当し、被害額を年間約21億円から約15億円に減らしました。
ここが評価される
データアナリストとの違いを一言で伝える
集計・可視化・効果検証が中心の仕事と、予測モデルを作って業務に組み込む仕事では、見られる経験が違います。要約に「モデルの構築と運用」のように担当範囲を書くと、読み違えられにくくなります。
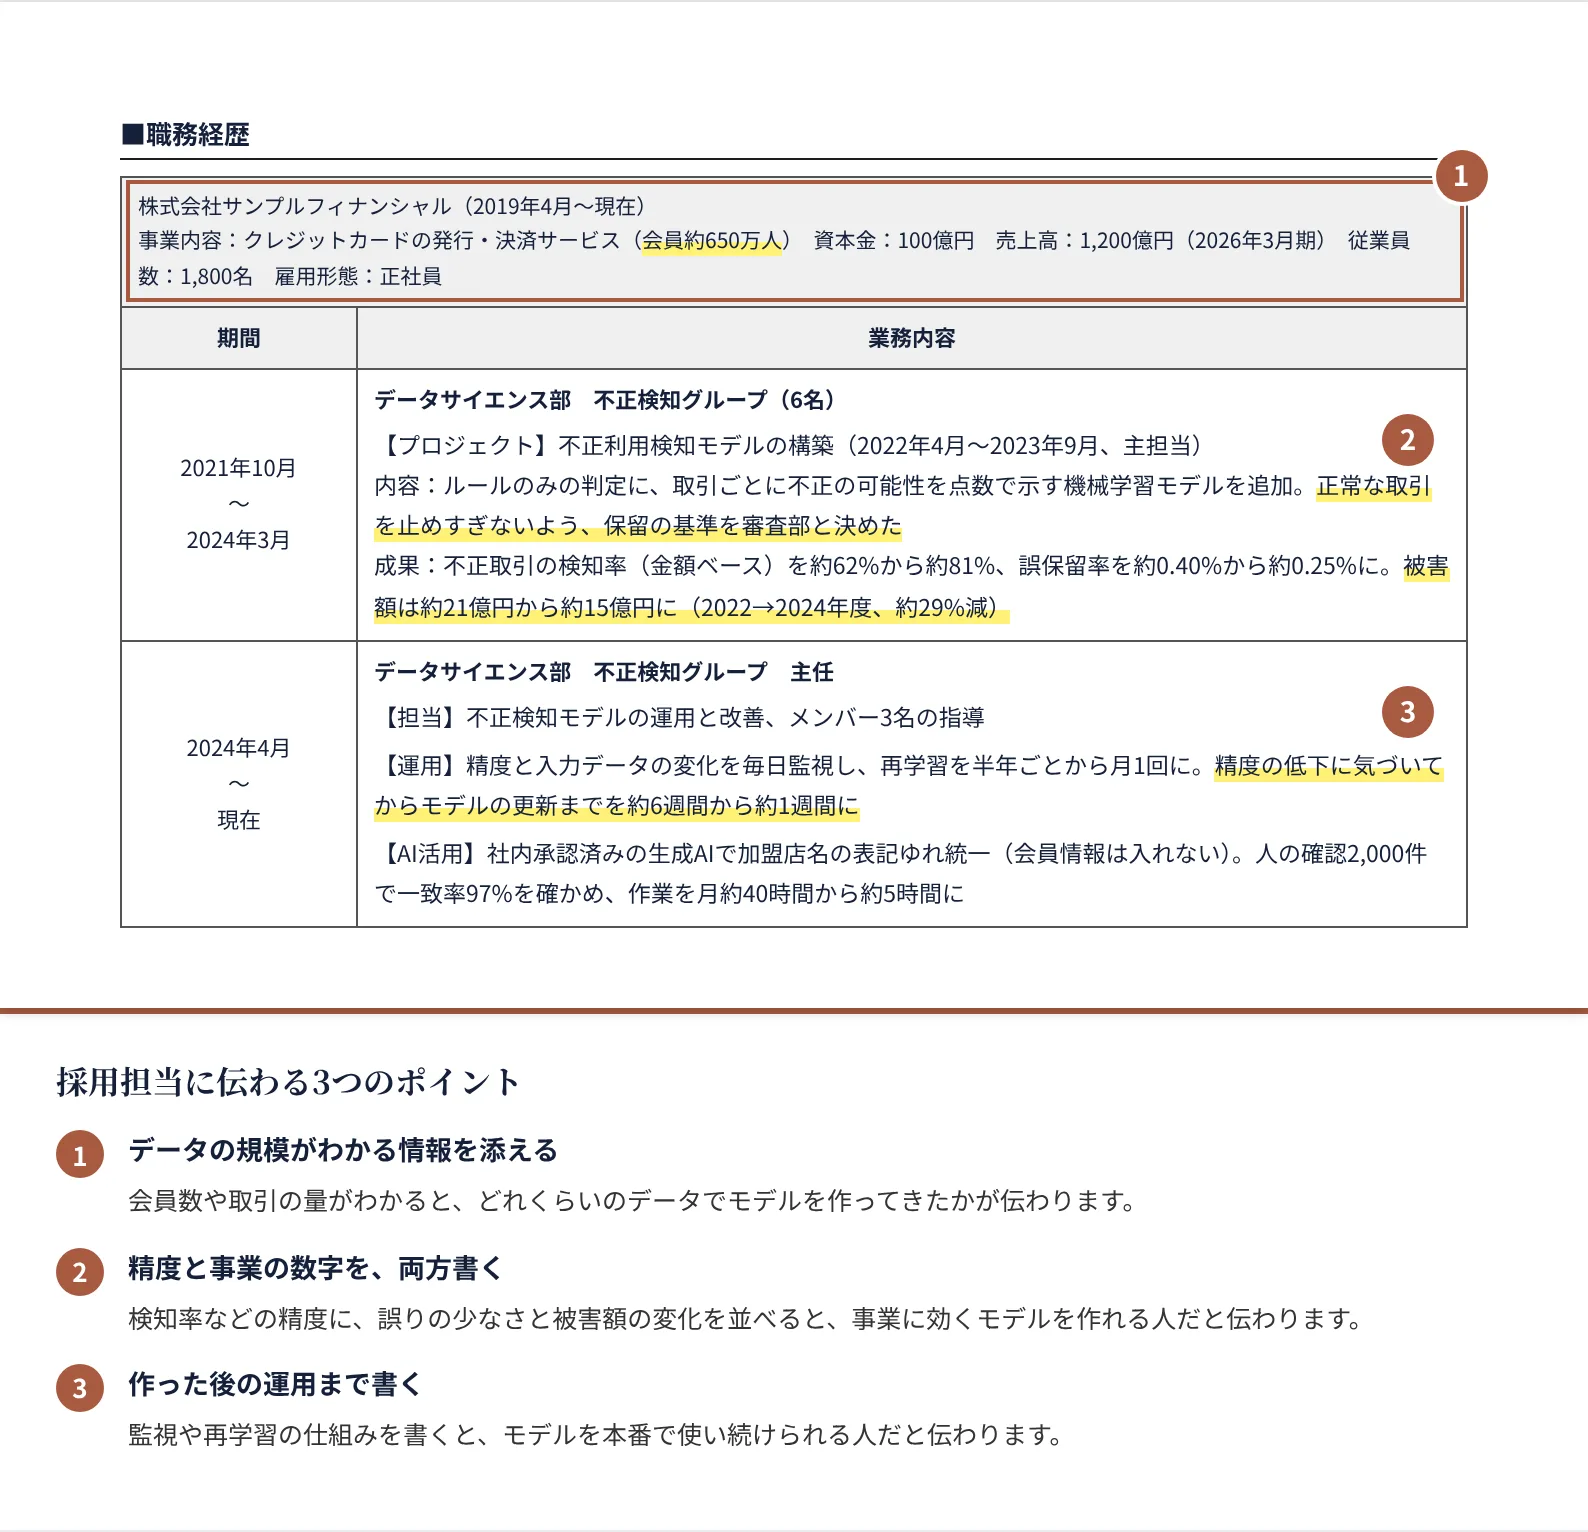
職務経歴は、データサイエンティストの書類でいちばん重要な項目です。下の画像の3つのポイントを押さえると、同じ経験でも伝わり方が大きく変わります。
× NG例
不正検知モデルの開発を担当。LightGBMを用いて特徴量エンジニアリングとハイパーパラメータ調整を行い、AUC0.95を達成しました。
ここが惜しい
○ OK例
【プロジェクト】不正利用検知モデルの構築(2022年4月〜2023年9月、主担当)
内容:ルールのみの判定に、取引ごとに不正の可能性を点数で示す機械学習モデルを追加。正常な取引を止めすぎないよう、保留の基準を審査部と決めた
成果:不正取引の検知率(金額ベース)を約62%から約81%、誤保留率を約0.40%から約0.25%に。被害額は約21億円から約15億円に(2022→2024年度、約29%減)
ここが評価される
記入例では、延滞予測、不正利用検知、運用の主任と、扱うモデルや立場が変わるたびに期間を分けています。大きな仕事は【プロジェクト】として、期間・役割・内容・成果に分けています。「内容」には、モデルが業務の中で何をするのかを一文で書くのがコツです。「取引ごとに不正の可能性を点数で示す」と書けば、専門家でなくても役割がわかります。
手法の名前より「何を解いたか」
使ったアルゴリズムやライブラリはテクニカルスキル欄にまとめ、職務経歴には課題・モデルの役割・評価の基準・成果を書きます。書類を最初に読むのは、データサイエンスの専門家でないことも多いからです。
精度の改善は、データサイエンティストの成果としていちばん書きやすい数字です。ただし、精度だけでは事業への効果が伝わりません。精度 → 業務での使い方 → 業務や事業の数字の順につなげて書きます。
× NG例
延滞予測モデルを改善し、精度を大幅に向上させました。
ここが惜しい
○ OK例
【成果】精度(AUC)を0.76から0.82に改善。審査部と運用ルールを決め、同じ延滞の捕捉数のまま、審査担当者が確認する件数を月約1.2万件から約8,000件に
ここが評価される
記入例の延滞予測では、AUC(モデルが延滞する会員とそうでない会員をどれだけ見分けられるかを示す指標)の改善を、審査担当者が確認する件数の減少につなげています。「同じ延滞の捕捉数のまま」と条件をそろえているので、件数の減少がモデルの改善によるものだと読み取れます。
データの章で見たように、同じ現象でも、何と比べるかで見え方は変わります。被害額や売上のように、モデル以外の要因でも動く数字を書くときは、比べた期間と、同じ期間に起きたほかの変化に触れると誠実です。
比べる条件をそろえて書く
精度の改善を書くときは、同じデータ・同じ期間で比べたのか、条件をそろえたことがわかるように書きます。被害額や売上の変化は、ほかの要因も影響するため、モデル以外の変化(取扱高の増減など)があれば一言添えると誠実です。
生成AIを業務で使った経験は、職務経歴の中に短く書くのが基本です。データサイエンティストなら、人が確認したデータで精度を測ってから使ったことまで書くと、ほかの職種との違いが出ます。
× NG例
生成AI・LLMを活用したデータ分析の高度化に取り組みました。
ここが惜しい
○ OK例
【AI活用】社内承認済みの生成AIで加盟店名の表記ゆれ統一(会員情報は入れない)。人の確認2,000件で一致率97%を確かめ、作業を月約40時間から約5時間に
ここが評価される
記入例では、テクニカルスキル欄にも「生成AI」の行を設け、使い方と期間を書いています。生成AIを使っていない人は、この行を削り、前処理や再学習の自動化など、仕事の進め方を変えた経験を書けば十分です。詳しくは後の「2026年のデータサイエンティストとAI」の章で解説します。
テクニカルスキル欄は、分類ごとに分けて、経験年数を添えます。ライブラリの名前をたくさん並べるより、手法の系統と、関わり方を書くほうが、経験の幅と深さが伝わります。
× NG例
Python、R、SQL、scikit-learn、LightGBM、PyTorch、AWS、Docker、Airflow、生成AI
ここが惜しい
○ OK例
機械学習:勾配ブースティング・ロジスティック回帰などの予測モデル構築と評価設計(10年半)
言語・データ:Python(10年半)、SQL(10年半)、R(3年)
基盤・運用:クラウド上の学習・推論の環境構築(5年)、モデル監視・再学習の自動化(2年半)
ここが評価される
経験年数は、職務経歴の期間と合わせて数えます。記入例では、受託会社のころから使っているPythonとSQLは10年半、前職だけで使ったRは3年としています。応募先の求人票に書かれている技術を使ったことがあれば、その名前は省かずに書きましょう。資格は、統計検定やG検定などを持っていれば、正式な名称と取得年月を書きます。
自己PRは「強み → 具体的な行動 → 結果の数字」の順に書きます。データサイエンティストの自己PRは「最新技術のキャッチアップ」「高精度なモデル」になりがちですが、採用担当が知りたいのは、その強みで事業がどう良くなったかです。
× NG例
最新の論文や技術を常にキャッチアップし、高精度なモデルを構築することが得意です。データから価値を生み出すことにやりがいを感じています。
ここが惜しい
○ OK例
モデルの精度を、事業の成果につなげる力
不正検知では、検知率と誤保留率の両方を審査部と決めて導入し、被害額を約21億円から約15億円に減らしました。
ここが評価される
2つ目の強みには、記入例のように「作ったモデルを、使われ続ける形にする力」など、作った後の仕事を選ぶのがおすすめです。モデルを作れる人は多くても、本番で精度を保ち続ける仕組みを作れる人は限られるからです。
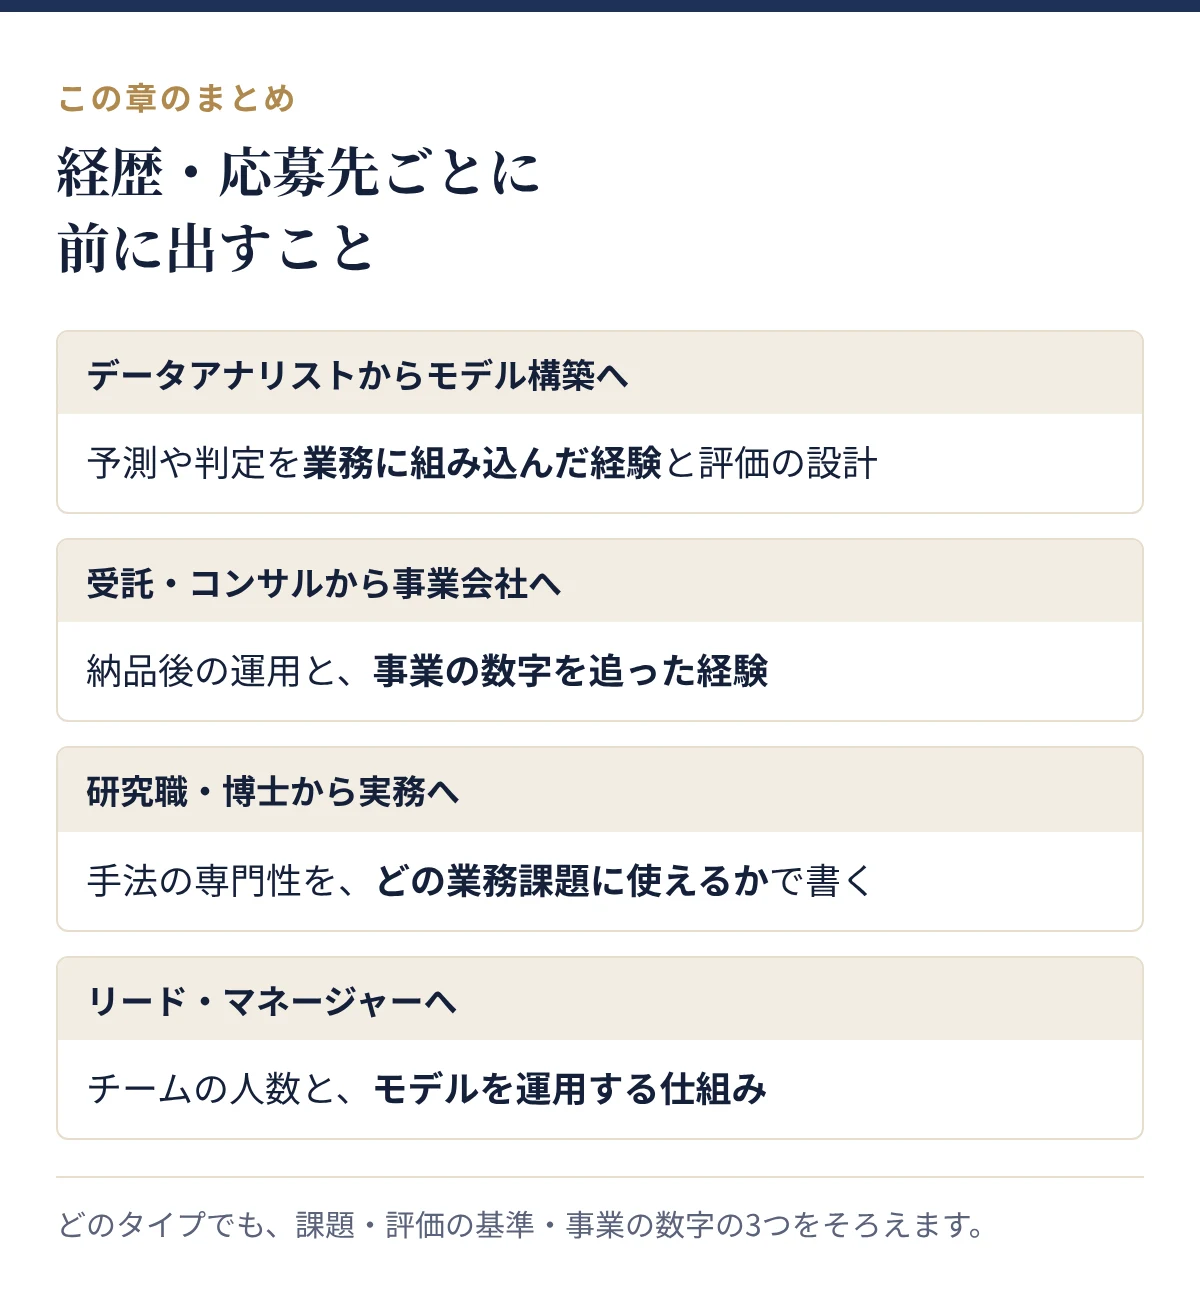
データサイエンティストは、これまでの経歴と応募するポジションによって、採用担当が気にすることが変わります。どのタイプでも共通するのは、課題・評価の基準・事業の数字の3つをそろえることです。まずは表で全体像を確認しましょう。
| タイプ | 採用担当が見るポイント | 前に出すこと |
|---|---|---|
| データアナリストからモデル構築へ | 予測や判定のモデルを業務に組み込めるか | 作ったモデルと評価の設計、業務での使われ方 |
| 受託・コンサルから事業会社へ | 納品後も事業の数字に責任を持てるか | 納品後の運用・改善、顧客の事業の数字の変化 |
| 研究職・博士から実務へ | 専門性を業務の課題に結びつけられるか | 手法の専門性、業務課題への応用、共同研究の成果 |
| リード・マネージャーへ | チームでモデルを作り、運用し続けられるか | チームの人数、運用の仕組み、育成 |
集計や可視化、効果検証を中心にしてきた人です。採用担当は、予測や判定のモデルを作り、業務の中で使われる形にした経験があるかを確かめます。分析の仕事の中から、予測や判定を使って業務を変えた経験を探して書きます。
職務経歴書に書きたいこと
記入例
※記入例とは別の架空例です
【プロジェクト】解約しそうな会員を予測するモデルを作成(Python)。カスタマーサポートが毎週電話する対象の選び方に組み込み
成果:電話した会員の3か月後の継続率は、同じ条件で選んだ電話しない会員より約4ポイント高い
ポイント
よくある落とし穴は、分析した件数やダッシュボードの数ばかりを書くケースです。モデル構築のポジションでは、件数より「予測を業務に組み込んで何が変わったか」が問われます。1件でもよいので、深く関わった予測の仕事を具体的に書きましょう。
採用担当は、納品で終わる働き方から、自社の事業の数字に長く責任を持つ働き方に移れるかを確かめます。納品の後にも関わった経験があれば、前に出しましょう。
職務経歴書に書きたいこと
記入例
【担当】小売・メーカー約10社の需要予測モデル構築と分析報告(Python・R)
【実績】食品メーカーの週次需要予測で、予測誤差(MAPE)を約25%から約15%に
ポイント
よくある落とし穴は、顧客名や案件の細部を書いてしまうケースです。受託の仕事には守秘義務があります。顧客は「食品メーカー」のように業界で書き、成果は割合で示しましょう。
大学や企業の研究所で、統計や機械学習を研究してきた人です。採用担当は、手法の専門性を、事業の課題に結びつけられるかを確かめます。論文の題名を並べるより、どんな課題に使える専門性かを書きます。
職務経歴書に書きたいこと
記入例
※記入例とは別の架空例です
【研究】時系列データの異常検知の手法を研究(博士課程、3年)。製造業との共同研究で、設備のセンサーデータ約5億件を扱い、故障の兆候を平均約2日早く検知
【発表】査読付き論文2本、国際学会での発表1件
ポイント
よくある落とし穴は、研究の新しさばかりを強調するケースです。実務では、新しい手法より、確実に効いて運用しやすい方法が選ばれることも多くあります。シンプルな手法と比べて検証した経験があれば、ぜひ書きましょう。
チームでモデルを作り、運用する責任を持つポジションです。採用担当は、自分が作るモデルだけでなく、チームとして精度を保ち続ける仕組みを作れるかを確かめます。
職務経歴書に書きたいこと
記入例
【担当】不正検知モデルの運用と改善、メンバー3名の指導
【運用】精度と入力データの変化を毎日監視し、再学習を半年ごとから月1回に。精度の低下に気づいてからモデルの更新までを約6週間から約1週間に
ポイント
よくある落とし穴は、自分が作ったモデルの精度ばかりを書くケースです。リードとして応募するなら、チームで作るモデルの数や、運用の仕組み、メンバーの育成を中心に書きましょう。
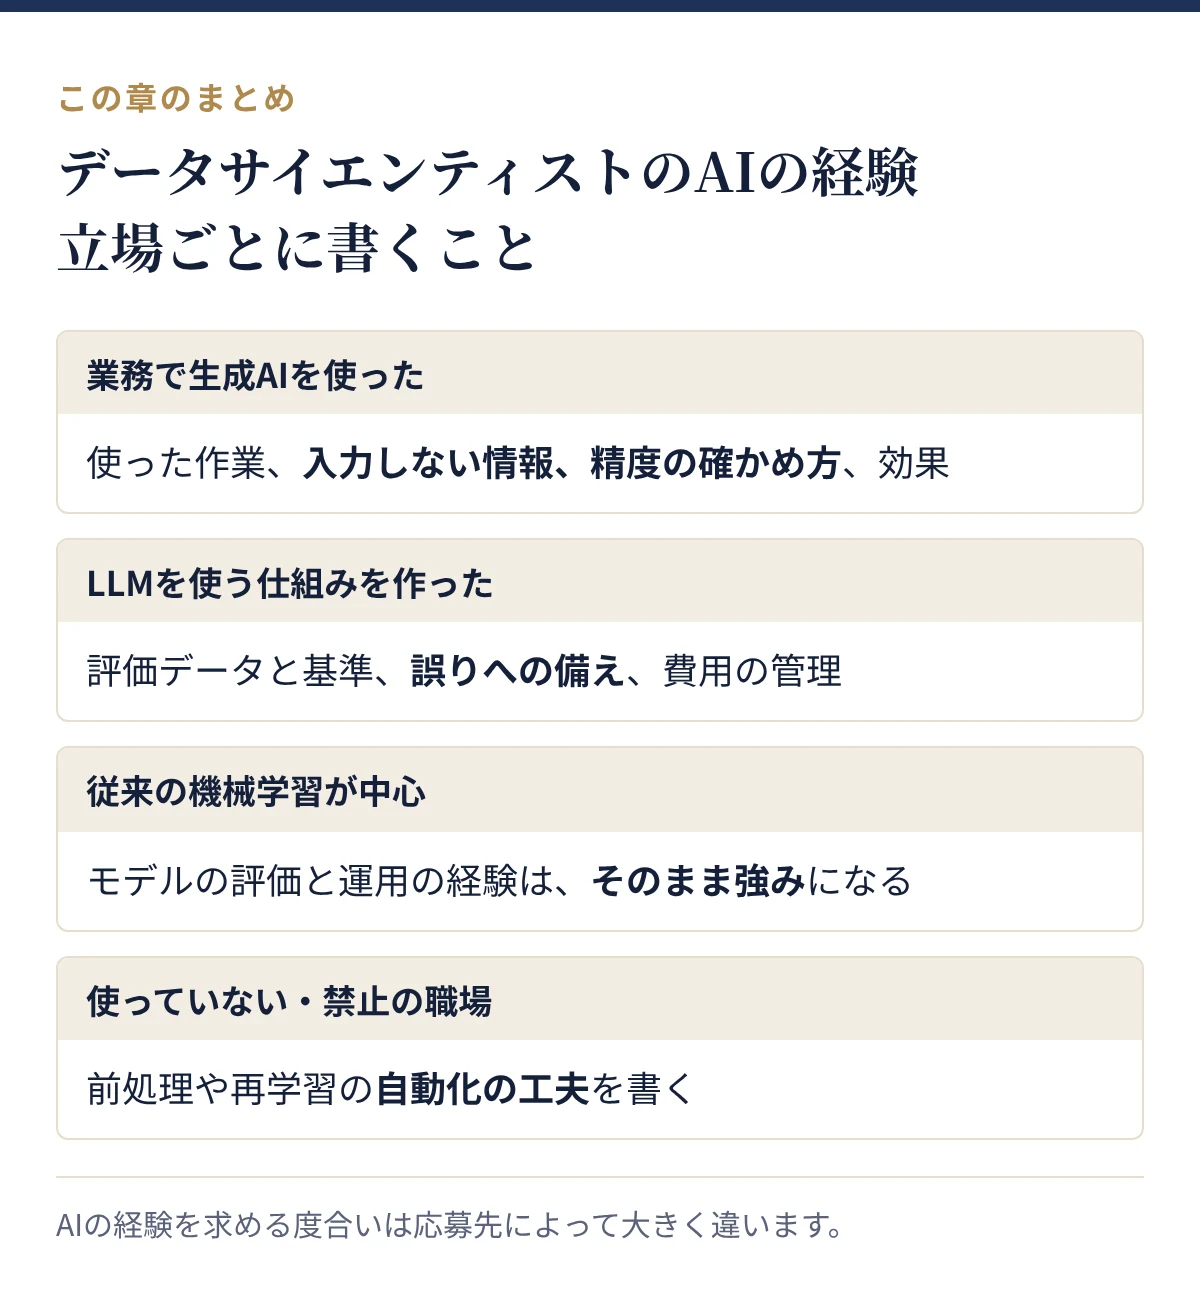
最初にお伝えしたいのは、AIの使い方や、生成AIの経験を求める度合いは、応募先によって大きく違うということです。IPAの「DX動向2026」プレス発表では、AIを導入している企業は従業員1,001人以上で8割近くにのぼる一方、101人以下では16.6%でした。
データサイエンティストは、もともと機械学習というAIの技術を扱う仕事です。生成AIを使った経験がないからといって、書類選考で不利になると考える必要はありません。まずは求人票に「生成AI」「LLM」などの言葉があるかを確認し、記載があれば具体的に書き、なければ1行添える程度で十分です。
パーソルキャリアの「企業のAI活用実態と人材戦略に関する調査」では、AIを導入・活用している従業員501人以上の企業の人事・採用担当者515人のうち、62.2%が今後3年以内に中途採用の人数に「変化がある」と答えました。増える領域で最も多かったのは、データ・デジタル/IT企画系でした。AIを導入済みの大企業に限った調査ですが、データを扱う人材への期待がうかがえます。
データサイエンティストとAIの関わりは、大きく2つに分かれます。1つは、コードの作成やテキストデータの整理など、自分の業務に生成AIを使うこと。もう1つは、LLM(大規模言語モデル)を使った仕組みを作り、その精度を評価することです。職務経歴書でも、この2つを分けて書くと、経験が正確に伝わります。
2026年時点で、データサイエンティストの業務で現実的な使い方は次のようなものです。どれも、出力をそのまま使わず、人が確かめてから使う使い方です。
| 使い方 | 具体例 | 人が確かめること |
|---|---|---|
| テキストの整理 | 店名や商品名の表記ゆれをそろえる、自由記述を分類する(記入例の使い方) | 人が確認したデータとの一致率 |
| コードの下書き | 集計のSQLや前処理のPythonの下書きを作る | 結果を別の方法で確かめたか、レビューを通したか |
| 調査・読解 | 初めて使う手法の論文やライブラリの説明を読む助けにする | 元の論文や公式の資料で確かめたか |
| 報告の下書き | 分析結果の要約や、業務部門向けの説明文の下書き | 数字や結論が元の分析と合っているか |
特に注意したいのが、データそのものの扱いです。会員情報や取引データなど、個人に関わるデータを外部のAIツールに入力することは、多くの会社で禁じられています。記入例では「会員情報は入れない」と明記し、加盟店名という公開されている情報の整理に使い方を限っています。
項目別の書き方で紹介したとおり、記入例では【AI活用】に「人の確認2,000件で一致率97%を確かめ」と書いています。生成AIの出力にも誤りがあることを前提に、採用する前に精度を測ったことが伝わる書き方です。これはデータサイエンティストならではの強みで、ほかの職種のAIの経験と差がつくポイントです。
一致率を測るときに使ったデータの件数、人がどう確認したか、基準に届かなかったときにどうするかを決めていたなら、それも書けます。効果は「作業を月約40時間から約5時間に」のように、使った作業に限って書きましょう。
LLMを使った分類や要約、問い合わせへの回答の仕組みを作った人は、作った仕組みの名前より、どう評価し、誤りにどう備えたかを書きます。正解が一つに決まらない出力を評価する経験は、多くの会社で求められ始めています。
記入例
※記入例とは別の架空例です
【プロジェクト】社内承認済みのLLMで、不正の疑いがある取引の確認メモを要約する仕組みを試作。審査担当者2名と作った評価用データ300件で、要約の誤りを分類して測定し、誤りが3%未満になるまで指示文と入力の形を改善。要約は判断の参考にとどめ、確定は担当者が行う運用に
ポイント
費用や応答時間をどう管理したか、出力が毎回少しずつ変わることにどう対応したかも、書ける点です。ただし、精度の数字は、きちんと測ったものだけを書きましょう。
金融や医療など、厳しいデータの規程がある職場では、生成AIのツールを使えないことは珍しくありません。規程に従ってデータを守りながらモデルを作り、運用してきたことは、データサイエンティストとして大切な経験です。
代わりに、前処理や再学習を自動化した経験を書きましょう。記入例の「精度と入力データの変化を毎日監視し、再学習を半年ごとから月1回に」のように、仕組みで仕事を速く確かなものにした経験は、生成AIの経験と同じく「仕事のやり方を変えられる力」を示します。
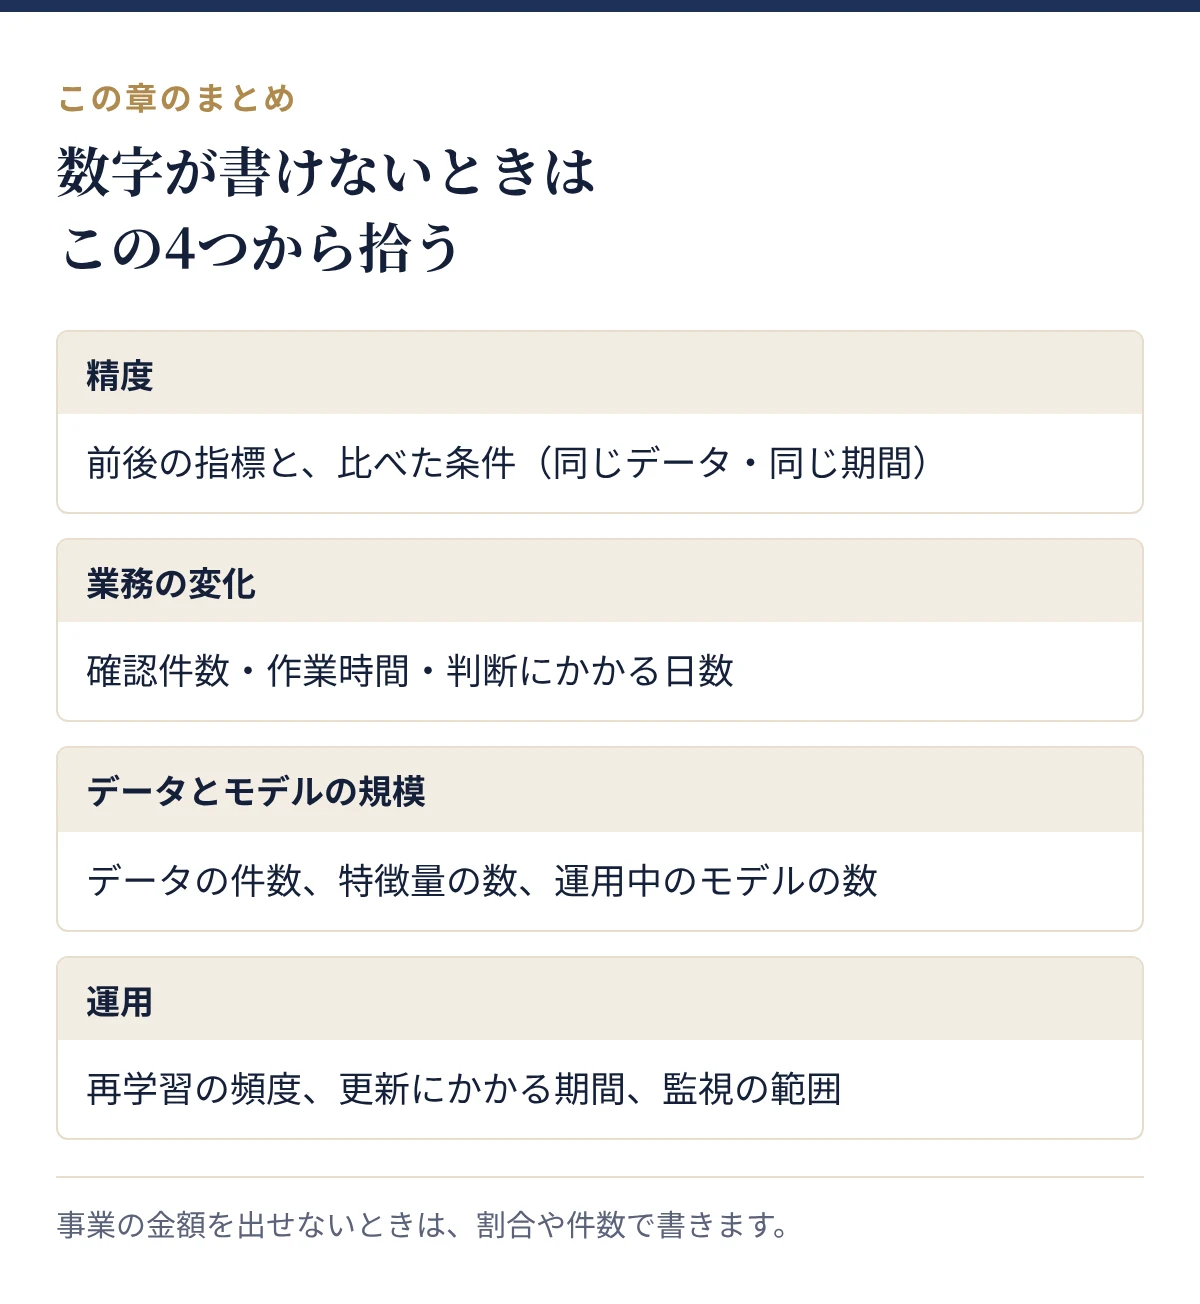
データサイエンティストの仕事は数字を扱う一方で、「事業への効果は社外秘」「モデルが本番に入らなかった」という人も少なくありません。精度・業務の変化・データとモデルの規模・運用の4つの切り口で探すと、書ける数字はたいてい見つかります。
被害額や売上など、事業の金額を社外に出せない
金額は割合や件数で書きます。
例:「不正利用の被害額を約29%削減」「審査担当者の確認件数を月約1.2万件から約8,000件に」
データの章で見たように、割合で書いても効果は十分に伝わります。社内の規程で禁じられた数字は書きません。
作ったモデルが、本番の業務に入らなかった
検証で確かめたことと、導入しないと判断した理由を書きます。
例:「検証で既存のルールより検知率は高かったが、誤保留が増えるため、審査部と協議して導入を見送り。代わりにルールの見直しに分析結果を活用」
導入しない判断も、事業への影響を考えた大切な仕事です。
チームでモデルを作っていて、自分の貢献を切り分けにくい
チームの成果と、その中で自分が担った部分を分けて書きます。
例:「不正利用検知モデルの構築(6名)。自身は特徴量の設計と、評価の基準づくりを担当」
担当した部分がはっきりすれば、成果を独り占めしなくても貢献が伝わります。
分析や研究が中心で、事業の数字に触れていない
扱ったデータの規模と、分析の結果で判断が変わったことを書きます。
例:「約3,000万件の購買データを分析し、出店の候補地を3か所から1か所に絞る根拠を提示」
判断の材料になった事実を書けば、事業への貢献は伝わります。
履歴書の学歴欄、入学・卒業の年で迷ったら
生年月日を選ぶだけで、入学・卒業の年月を和暦・西暦で計算し、学歴欄をそのまま作れます。早生まれ・浪人・留年にも対応しています。
職歴欄・資格欄・証明写真も、無料ツールでそろえられます。
履歴書・職務経歴書づくりに使える無料ツール一覧 ›
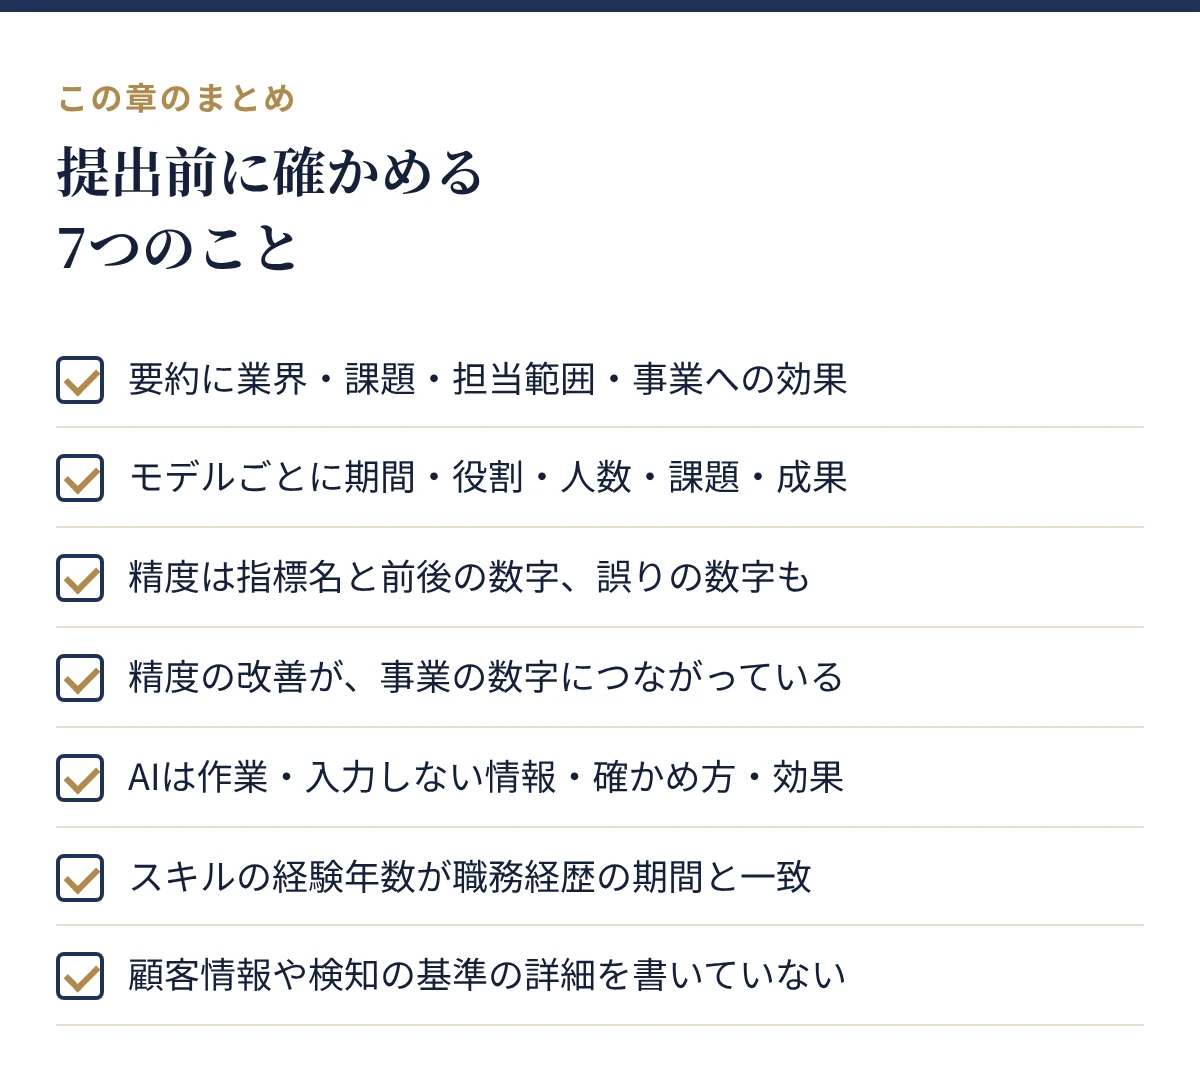
書き終えたら、提出前に次の項目を確認しましょう。
最後に、割合を計算し直しましょう。記入例なら、被害額は約15億円÷約21億円で約71%、つまり約29%減です。データを扱う職種だからこそ、書類の数字の計算が合っていることは、信頼の土台になります。
応募先の仕事に関係があれば書いてかまいません。職務経歴とは分けて「コンペ・論文」などの欄を作り、テーマ、順位や掲載先、扱ったデータの種類を書きます。業務の実績がある人は、そちらを中心にして、コンペや論文は補足にするとバランスがよくなります。
職務経歴では「機械学習モデル」「時系列の予測モデル」程度にとどめ、テクニカルスキル欄に手法の系統と年数を書くのがおすすめです。細かな工夫は面接で話せるように準備しておきましょう。
顧客の名前、検知や審査の基準の詳細、社外秘の数字は書きません。業界・業務・モデルの役割・割合で示した成果があれば、経験の中身は十分に伝わります。迷う場合は、社内の規程で公開できる範囲を確認しましょう。
学歴は履歴書に書くのが基本ですが、研究の内容が応募先の仕事に関係するなら、職務経歴書にも「研究テーマ」として短く書くと伝わりやすくなります。テーマ、手法、扱ったデータの規模を1〜2行でまとめましょう。
AIの活用をどの程度求めるかは応募先によって大きく違い、生成AIの経験がないことだけで不利になるとは限りません。モデルの評価や運用、前処理の自動化など、データサイエンティストとしての経験を、前後の数字とともに書きましょう。
この記事の記入例テンプレートを無料でダウンロード
Word・Excel・PDFの3形式に対応。空欄テンプレートと記入見本のセットです。