Guides
書き方ガイド
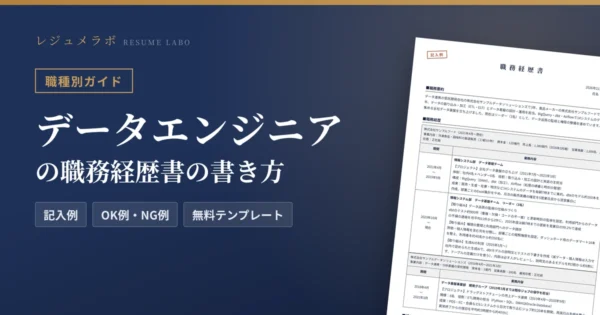
データエンジニアの職務経歴書でよくあるのが、「データ基盤の構築・運用を担当」「データ連携の開発でデータ活用に貢献」と書いて終わる書き方です。これでは、どのデータを、どこまで集めて、誰の仕事をどう変えたのかが読み手に見えません。採用担当が知りたいのは、集めてきたデータの範囲と使った道具、データ基盤が業務をどう変えたかの数字、そしてデータの品質と安全を守る仕組みです。
ひと言でいうと、データエンジニアは、社内のデータを集めて整え、決まった時刻までに使える状態にする仕事です。売上や在庫のデータは、ふだんは別々のシステムに入っています。それを1か所に集め、表記をそろえ、毎朝、分析やAIに使える形で用意します。問題なく動いている間は目立たない仕事なので、職務経歴書では成果を数字で示すことが大切です。
この記事は、データ基盤の仕事を続けて転職する人と、分析・BIやアプリ・インフラの仕事からデータエンジニアを目指す人に向けたものです。受託開発会社で3年、食品メーカーのデータ基盤チームで約5年半働いてきた人の記入例をもとに、項目ごとの書き方と、これまでの経歴ごとの書き分け、AIの経験の書き方を解説します。
無料テンプレート
データエンジニアの職務経歴書、記入見本つきのテンプレートがあります
この記事の記入例と同じ形式で、Word・Excel・PDFの3形式。空欄のテンプレートと記入見本がセットになっています。
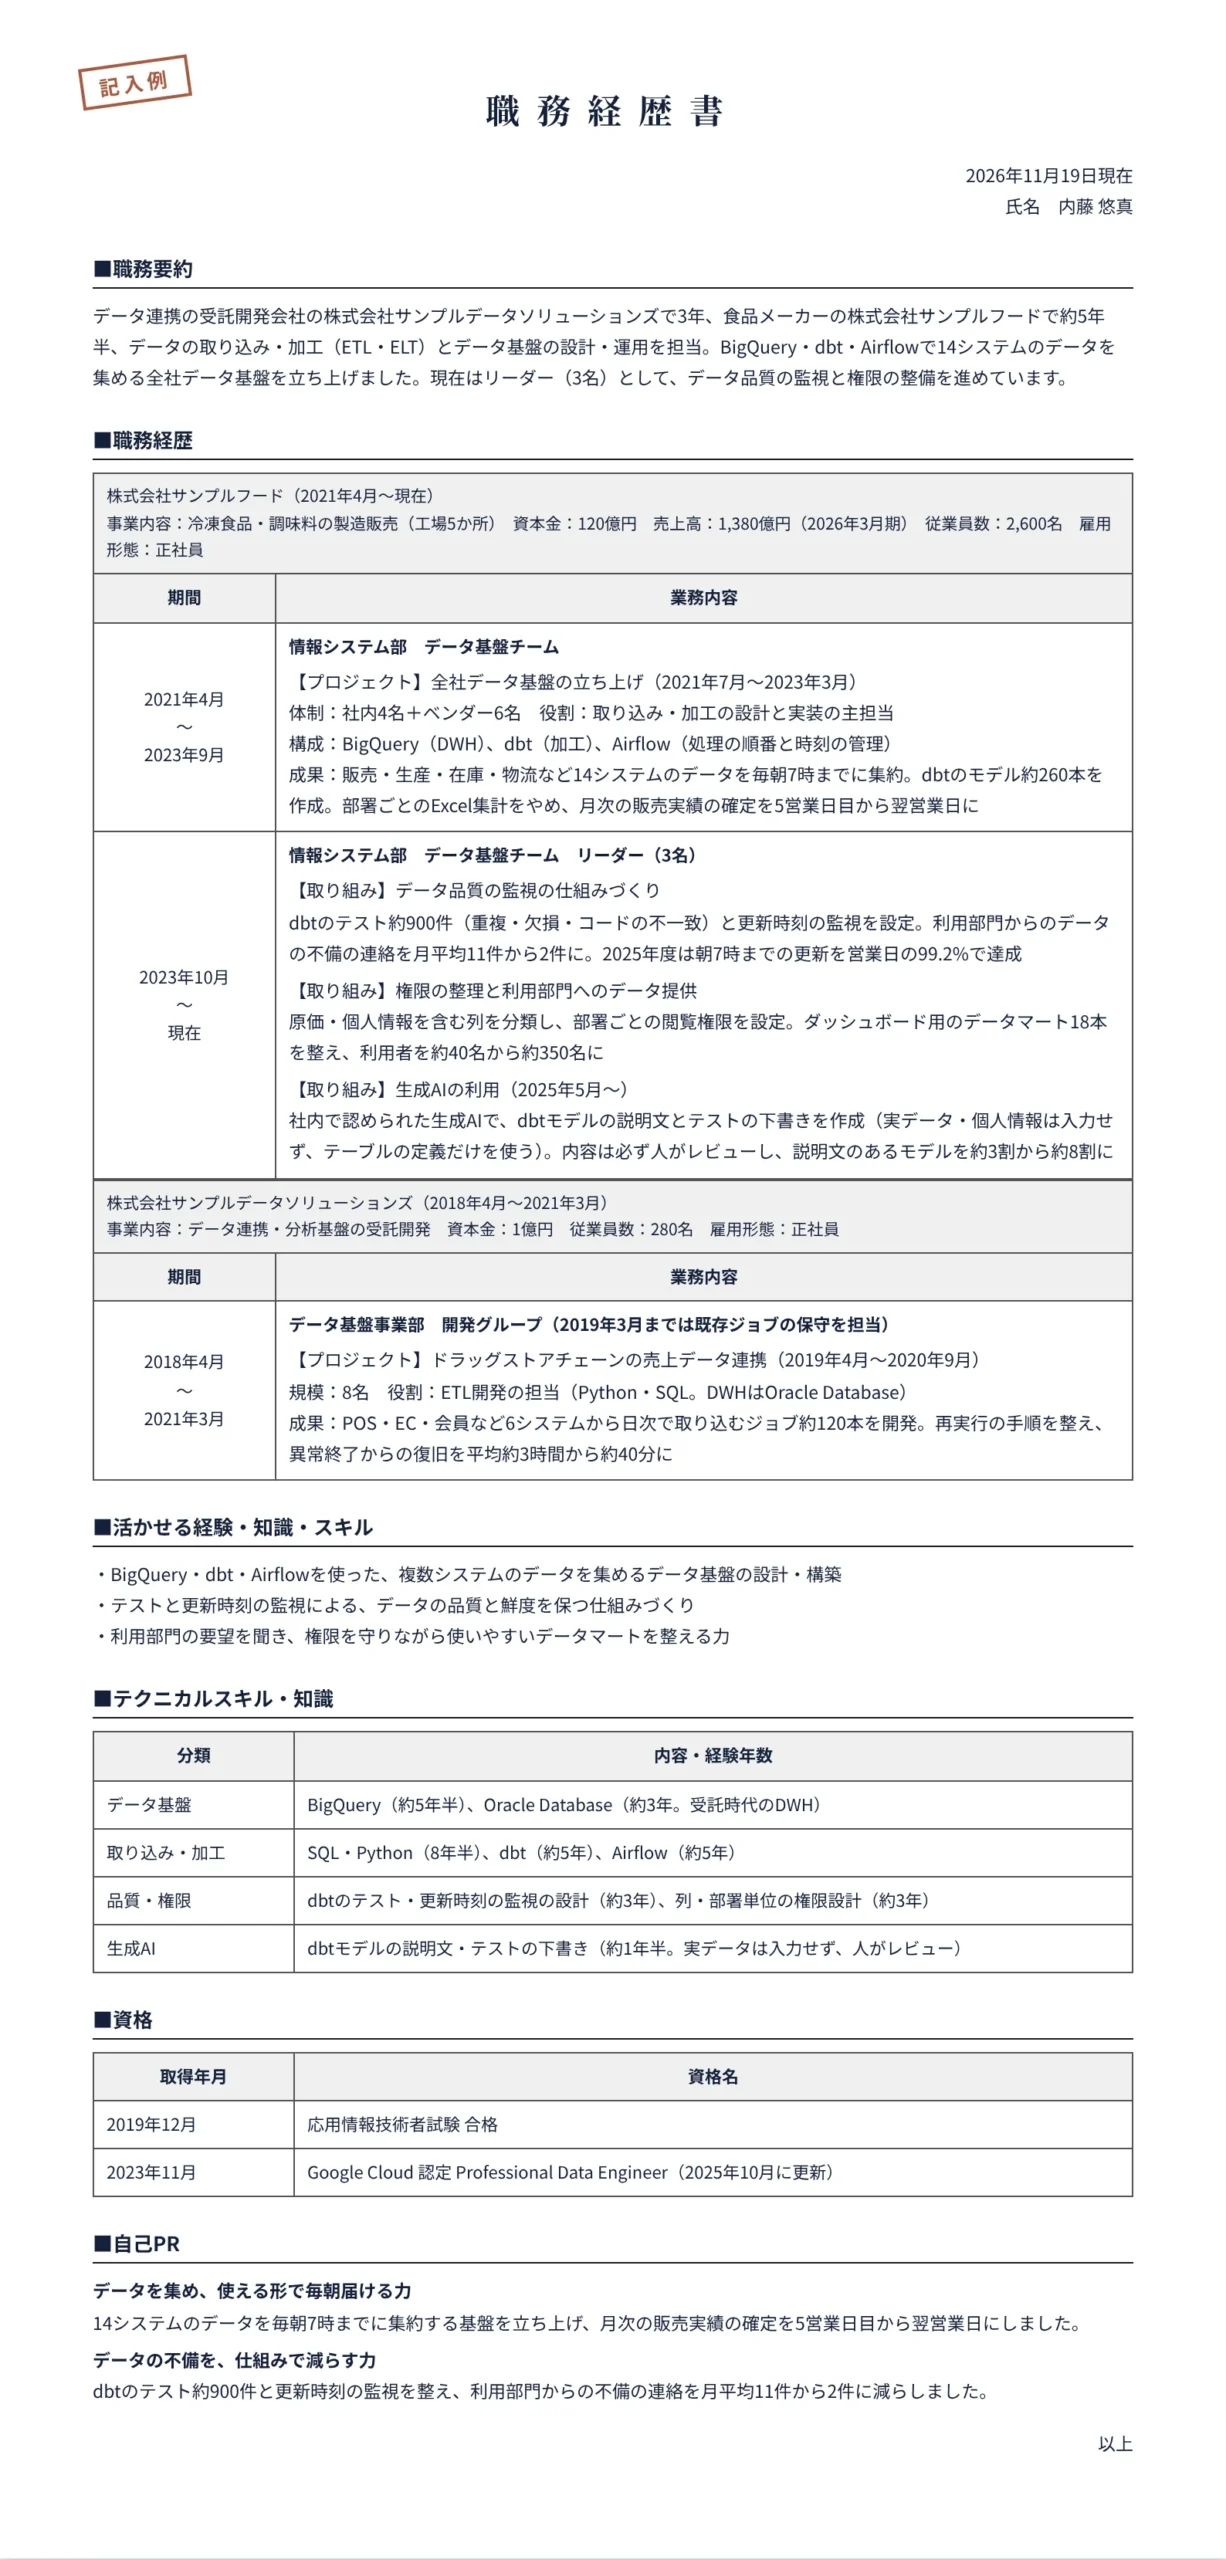
まずは完成イメージです。データ連携を請け負う開発会社に新卒で入り、ドラッグストアチェーンの売上データを毎日取り込む仕組みを開発しました。その後、食品メーカーに移り、14のシステムのデータを集める全社データ基盤を立ち上げた人を想定しています。現在はチームのリーダーとして、品質の監視と権限の整理を進めています。画像をタップすると拡大できます。
記入例に出てくる言葉を、先に短く説明しておきます。
この記入例と同じ形式のテンプレートを無料で用意しています。Word・Excel・PDFの3形式で、空欄テンプレートと記入見本の2点セットです。
記入例をもとに、あなたの経歴でデータエンジニアの職務経歴書を作る(AI職務経歴書メーカー・無料)
ツールで聞かれる質問や記入見本は、データエンジニアの職務経歴書をAIで作成するページで先に確かめられます。
書き方に入る前に、データエンジニアという仕事が公的なデータでどう描かれているかを見ておきます。厚生労働省の職業情報提供サイト「job tag」には、データエンジニアのページがあります。仕事の内容は「膨大なデータを分析するためにデータの整理や管理を行ったり、複雑で大規模なデータが活用できるよう情報基盤の構築や運用を行う」と説明されています。データエンジニアの仕事は、データの不備を直して整える作業と、基盤を止めずに動かす運用の両方でできています。職務経歴書でも、両方を数字で示しましょう。
job tag には、仕事の中のタスク(作業)ごとに、実際に行っている人の割合が載っています。厚生労働省が2023年度に行った調査の結果です。「データの加工、整理の方法について検討する」が97.7%、「データを加工するプログラムを作成する」が95.5%と、ほぼ全員が行っています。「欠損しているデータを補う」「データの修正や復旧を行う」も93.2%でした。
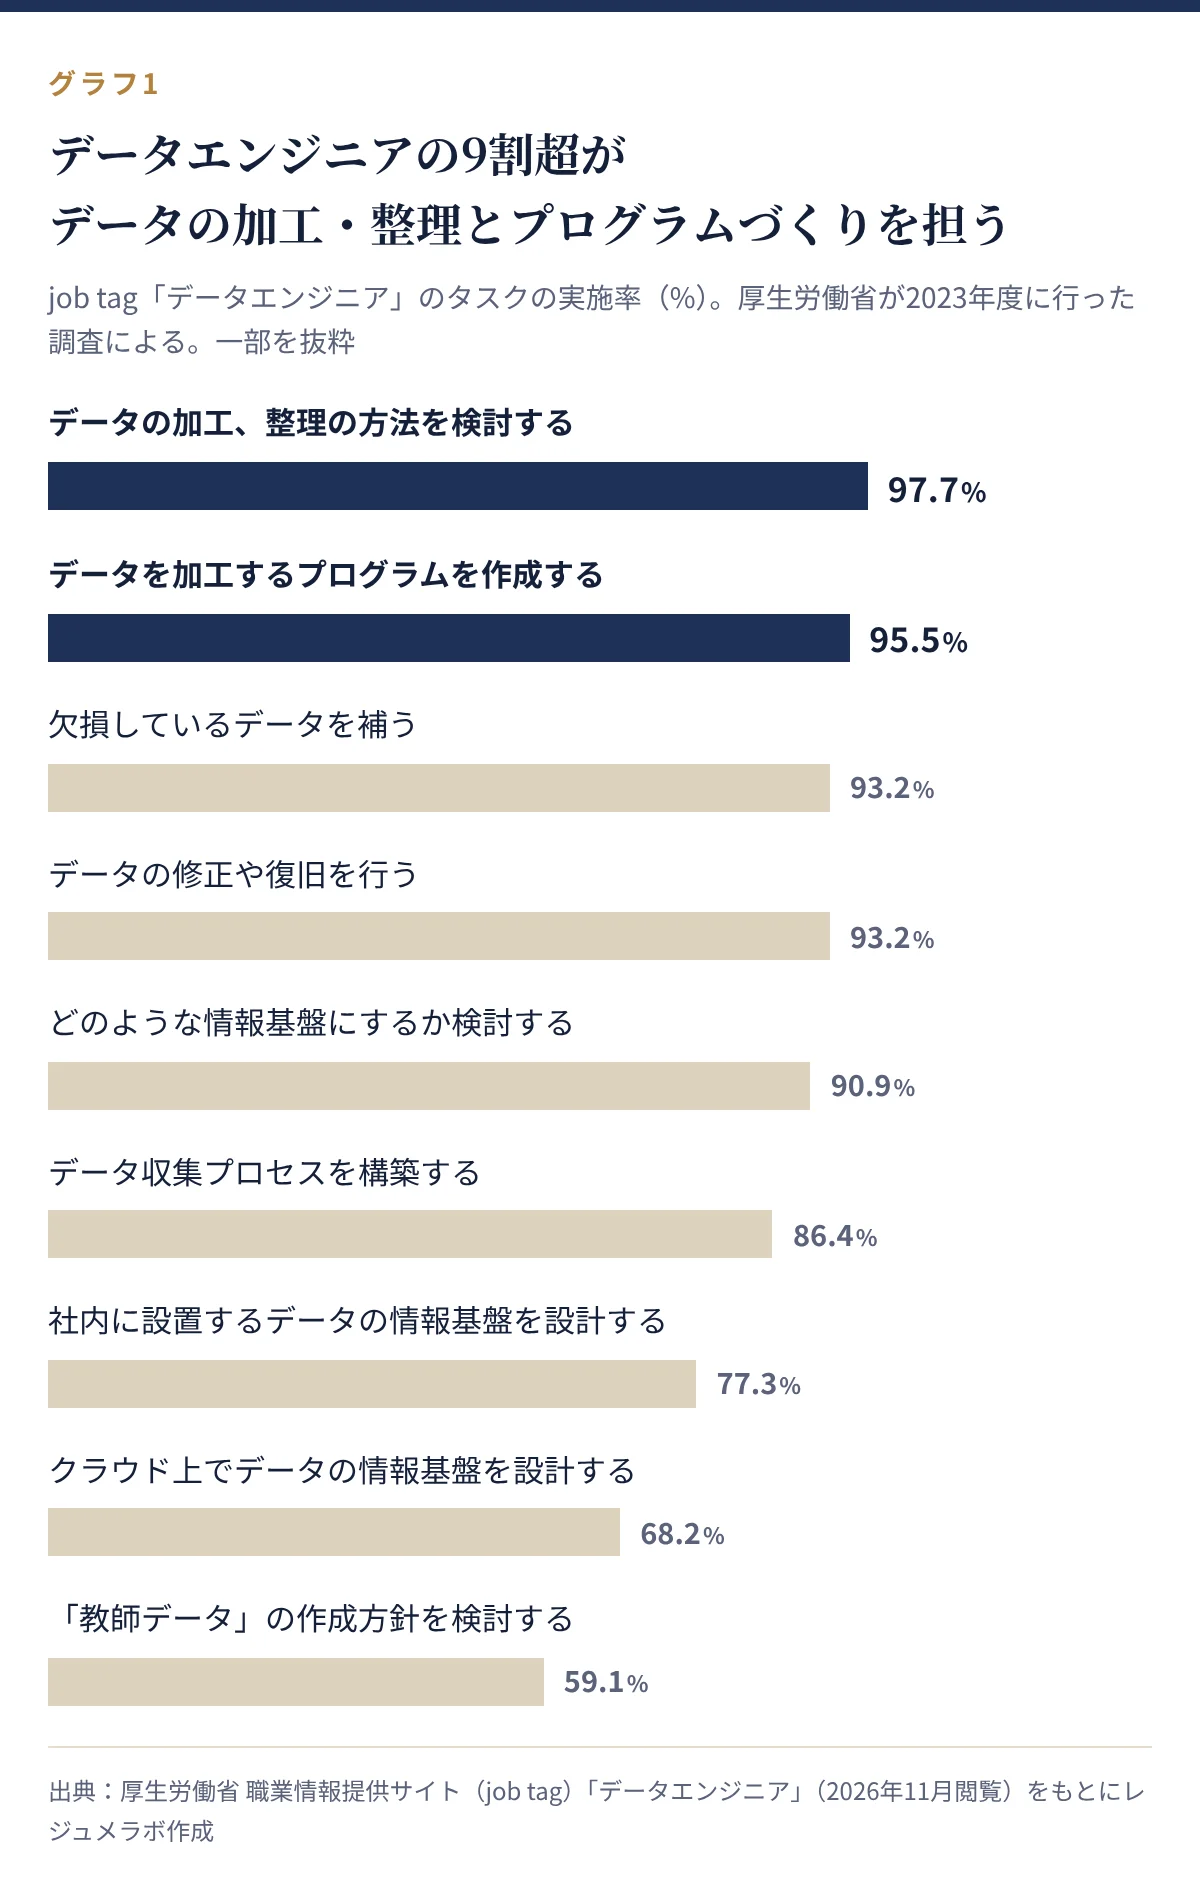
出典:厚生労働省 職業情報提供サイト(job tag)「データエンジニア」(2026年11月閲覧)
欠けたデータや表記の揺れを直す作業は、ほぼ全員が行っています。ただし、問題が起きなければ気づかれない作業なので、職務経歴書では省かれがちです。書くときは、不備を見つけて直す作業を自動化した結果を数字で示します。記入例は、テスト約900件を設定し、利用部門から届く不備の連絡が月平均11件から2件に減ったことを書いています。
job tag では、仕事に必要なスキルを0〜7点のスコアで示しています。近い職業のデータサイエンティスト(データを分析して、事業の課題に答えを出す専門職)と比べると、データエンジニアは「保守点検」が2.7点(データサイエンティストは2.0点)、「計器監視」が2.6点(同2.0点)と高くなっています。反対に、「数学的素養」はデータサイエンティストの5.1点に対して3.3点でした。
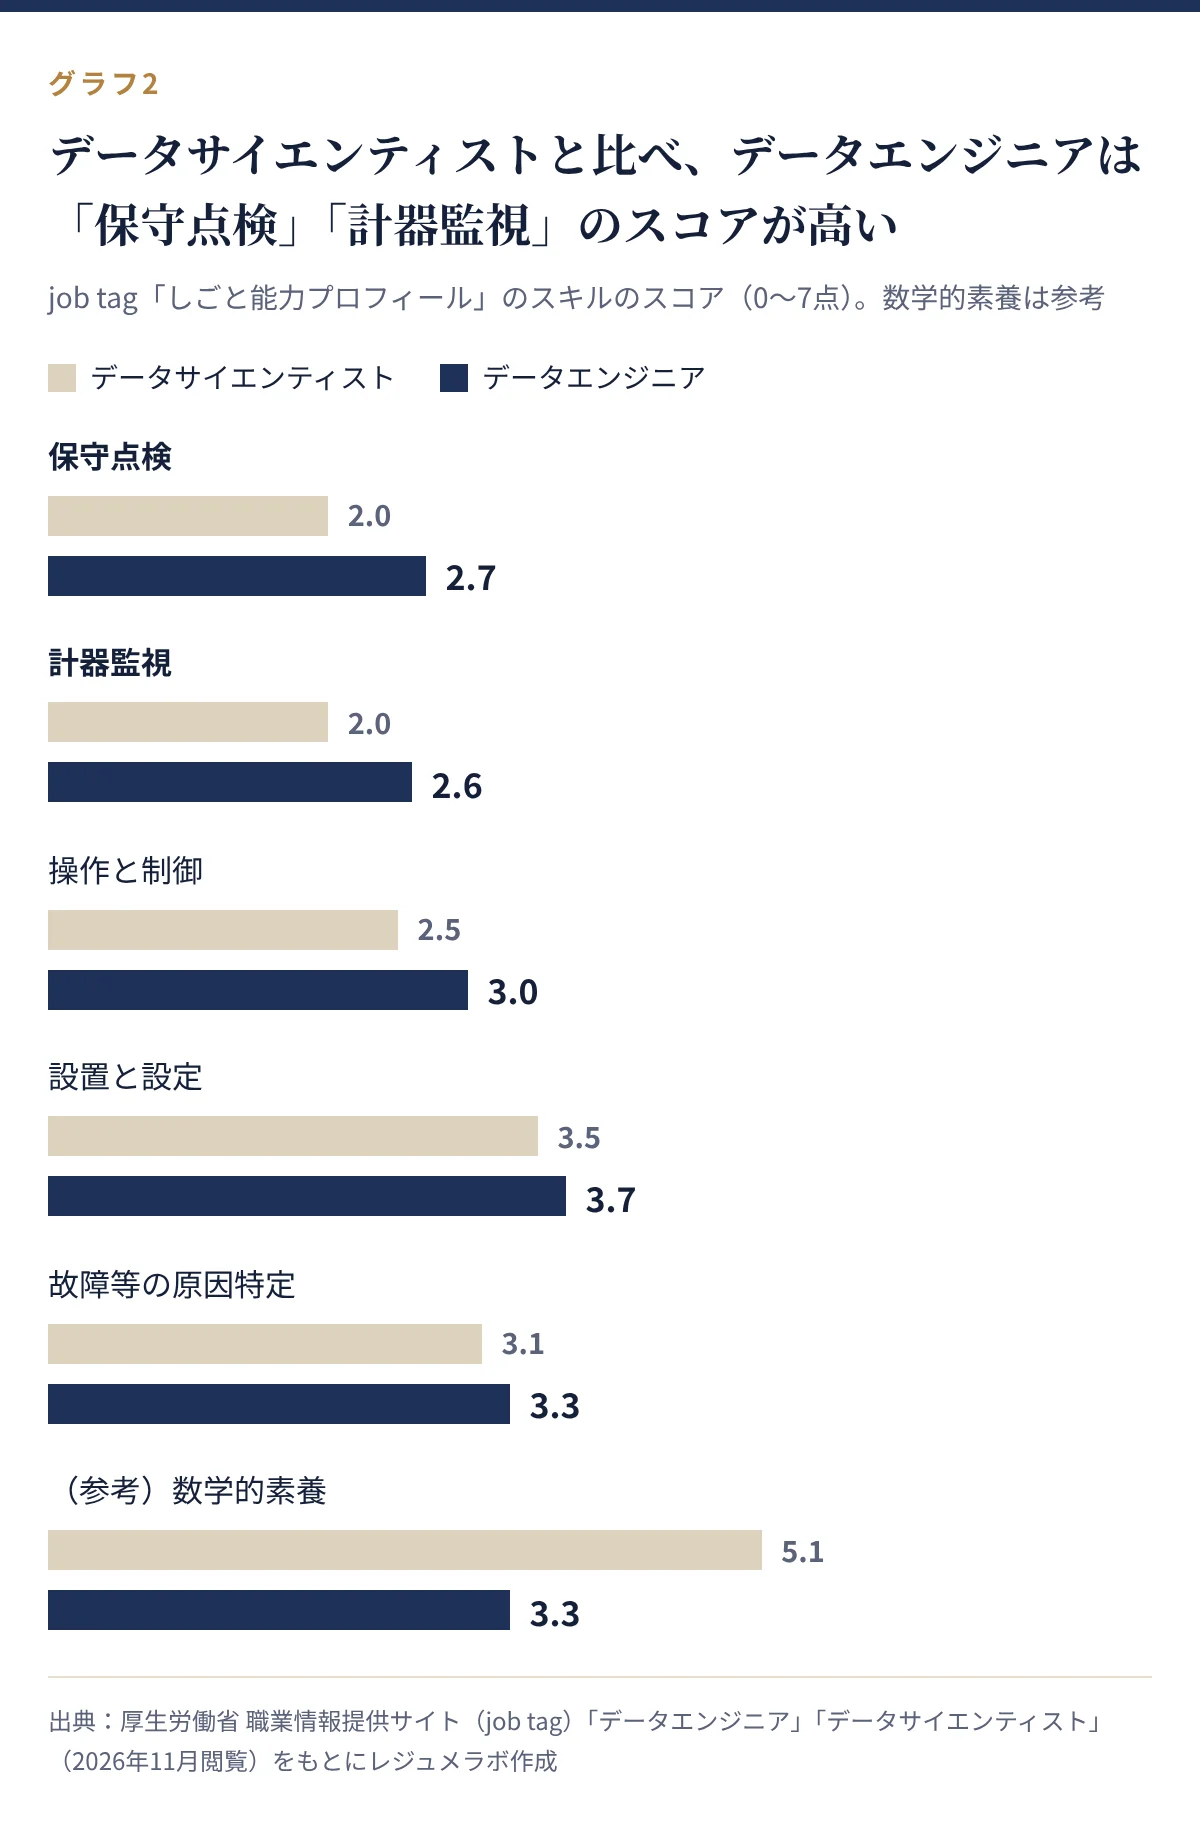
出典:厚生労働省 職業情報提供サイト(job tag)「データエンジニア」・「データサイエンティスト」(2026年11月閲覧)
データサイエンティストがデータから答えを出す仕事なら、データエンジニアは、その元になるデータを決まった時刻までに使える状態にする仕事です。毎日の運用は、書類では1行で済まされがちな部分です。記入例では、朝7時までの更新を営業日の99.2%で達成と、利用部門と約束した時刻を守れた割合を書いています。
同じタスクの一覧では、「クラウド上でデータの情報基盤を設計する」が68.2%、「社内に設置するデータの情報基盤を設計する」が77.3%でした。社内のサーバーに置く基盤に関わる人も多いということです。記入例の人は、受託時代はOracle Databaseを、現在はBigQueryをDWHに使っています。使った環境を「受託時代のDWH」のように時期と一緒に書くと、クラウドと社内のサーバーのどちらで経験を積んだかを、採用担当がすぐに確かめられます。
データを整える仕組みの結果と、時刻どおりに使える状態にした結果を、使った環境とあわせて数字で書く。データエンジニアの職務経歴書で差がつくのは、この点です。
米国では、データエンジニアは分析する人とは別の専門職として扱われています。日本ではまだ担い手が少なく、呼び方や仕事の範囲も会社によって違います。この違いを知っておくと、日本の職務経歴書でどこを詳しく書けばよいかがはっきりします。
米国の主要なクラウドの会社は、「データエンジニア」の名前で認定資格を出しています。Google CloudのProfessional Data Engineer、AWSのAWS Certified Data Engineer – Associate、MicrosoftのMicrosoft Certified: Fabric Data Engineer Associateです。また、dbtを開発するdbt Labsは、データエンジニアと分析者の間をつなぐ役割として「アナリティクスエンジニア」という職種名を示しています。
応募先の求人にこうした資格名や職種名が出ていれば、持っている資格は正式名称と取得年月で書きます。職種名が自分の肩書きと違っても、担った作業が同じなら、作業の中身で書けば十分です。
総務省の「令和8年版 情報通信白書」によると、「AI・データ解析の専門家」が社内にいると答えた企業は、日本が26.4%、米国が75.4%でした。システム開発を自社主導で行う企業も、日本は46.0%で、海外の約80%を下回っています。
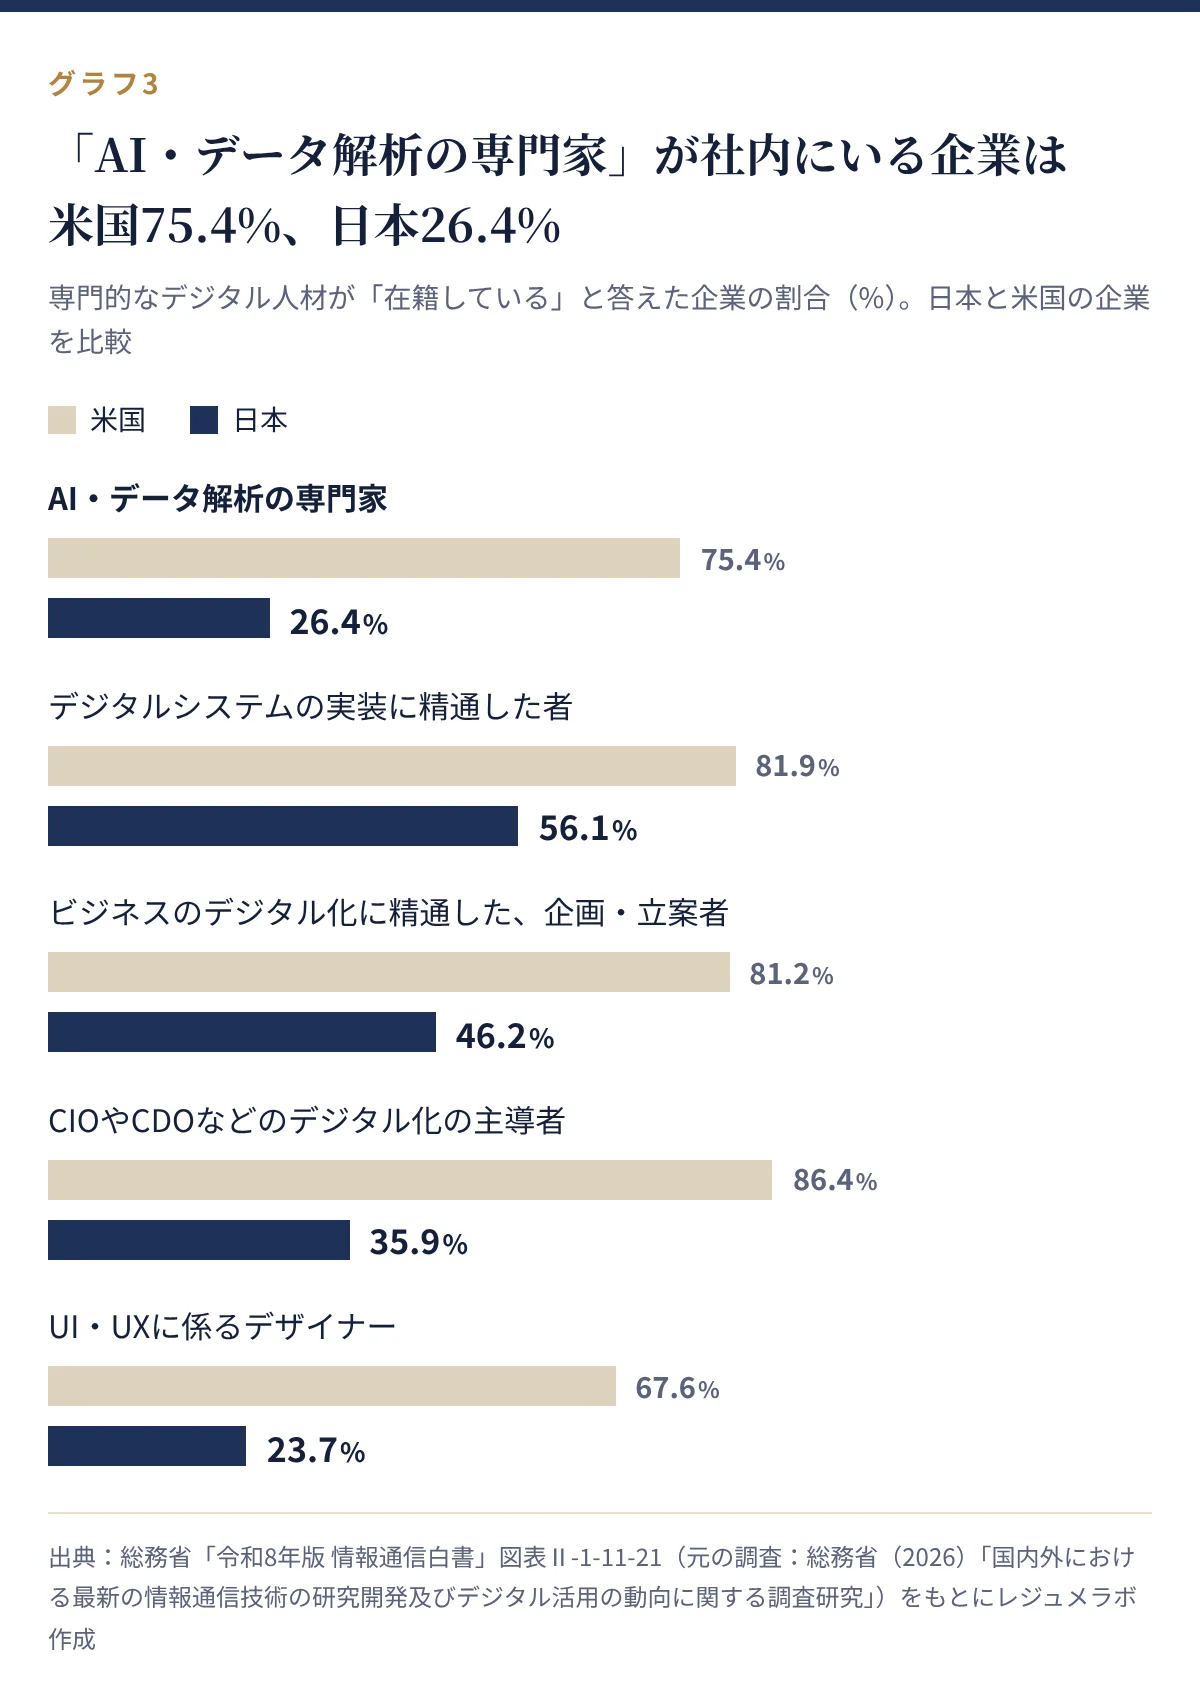
出典:総務省「令和8年版 情報通信白書」各国企業のデジタル化の状況(図表Ⅱ-1-11-21)
job tag も、日本のデータエンジニアは数万人程度と見積もり、勤め先はSIer(システムの開発を請け負う会社)やデータ分析の専門会社が中心としています。経済産業省とIPA(情報処理推進機構)が2026年4月に公開した「デジタルスキル標準 ver.2.0」では、データエンジニアが新しい「データマネジメント」という人材の分類に移りました。役割は、データの収集・統合・加工・提供の各段階での整備と、データパイプライン(データを流す仕組み)の設計・実装とされています(本文)。
日本では、呼び方も仕事の範囲もまだそろっていません。job tag には「ビッグデータエンジニア」という別名も載っています。取り込みだけを担う人もいれば、設計から権限まで任される人もいます。そこで職務経歴書には、次の3つを書きます。
記入例では、それぞれ「取り込み・加工の設計と実装の主担当」「社内4名+ベンダー6名」「月次の販売実績の確定を5営業日目から翌営業日に」が当たります。自社主導の開発がまだ少ない日本では、社内のチームとして基盤を立ち上げた経験は具体的な材料になります。受託の経験が中心の人も、顧客の業務がどう変わったかを書けば、同じように評価の材料になります。
データエンジニアの採用担当は、職務経歴書から主に次の3つを確かめています。
3つとも、答えになるのはシステムの数・時刻・件数・人数です。ツールも「クラウドのDWH」とぼかさず、ツールの名前と使った年数まで書きましょう。
ここからは項目ごとに、NG例とOK例を並べて解説します。OK例は記入例からの引用です。差がつきやすいのは、データ基盤の立ち上げと、データ品質・権限の書き方です。
データエンジニアは、受託で顧客の基盤を作ってきたか、事業会社で自社の基盤を育ててきたかで、経験の中身が大きく変わります。日本では役割の範囲が会社ごとに違うため(海外と日本の章を参照)、勤務先の種類と担った工程を最初の一文で示しましょう。
× NG例
データエンジニアとして、データ基盤の構築や運用に幅広く携わってきました。ETLの開発やデータ分析の支援を通じて、データ活用の推進に貢献しています。
ここが惜しい
○ OK例
データ連携の受託開発会社の株式会社サンプルデータソリューションズで3年、食品メーカーの株式会社サンプルフードで約5年半、データの取り込み・加工(ETL・ELT)とデータ基盤の設計・運用を担当。BigQuery・dbt・Airflowで14システムのデータを集める全社データ基盤を立ち上げました。現在はリーダー(3名)として、データ品質の監視と権限の整備を進めています。
ここが評価される
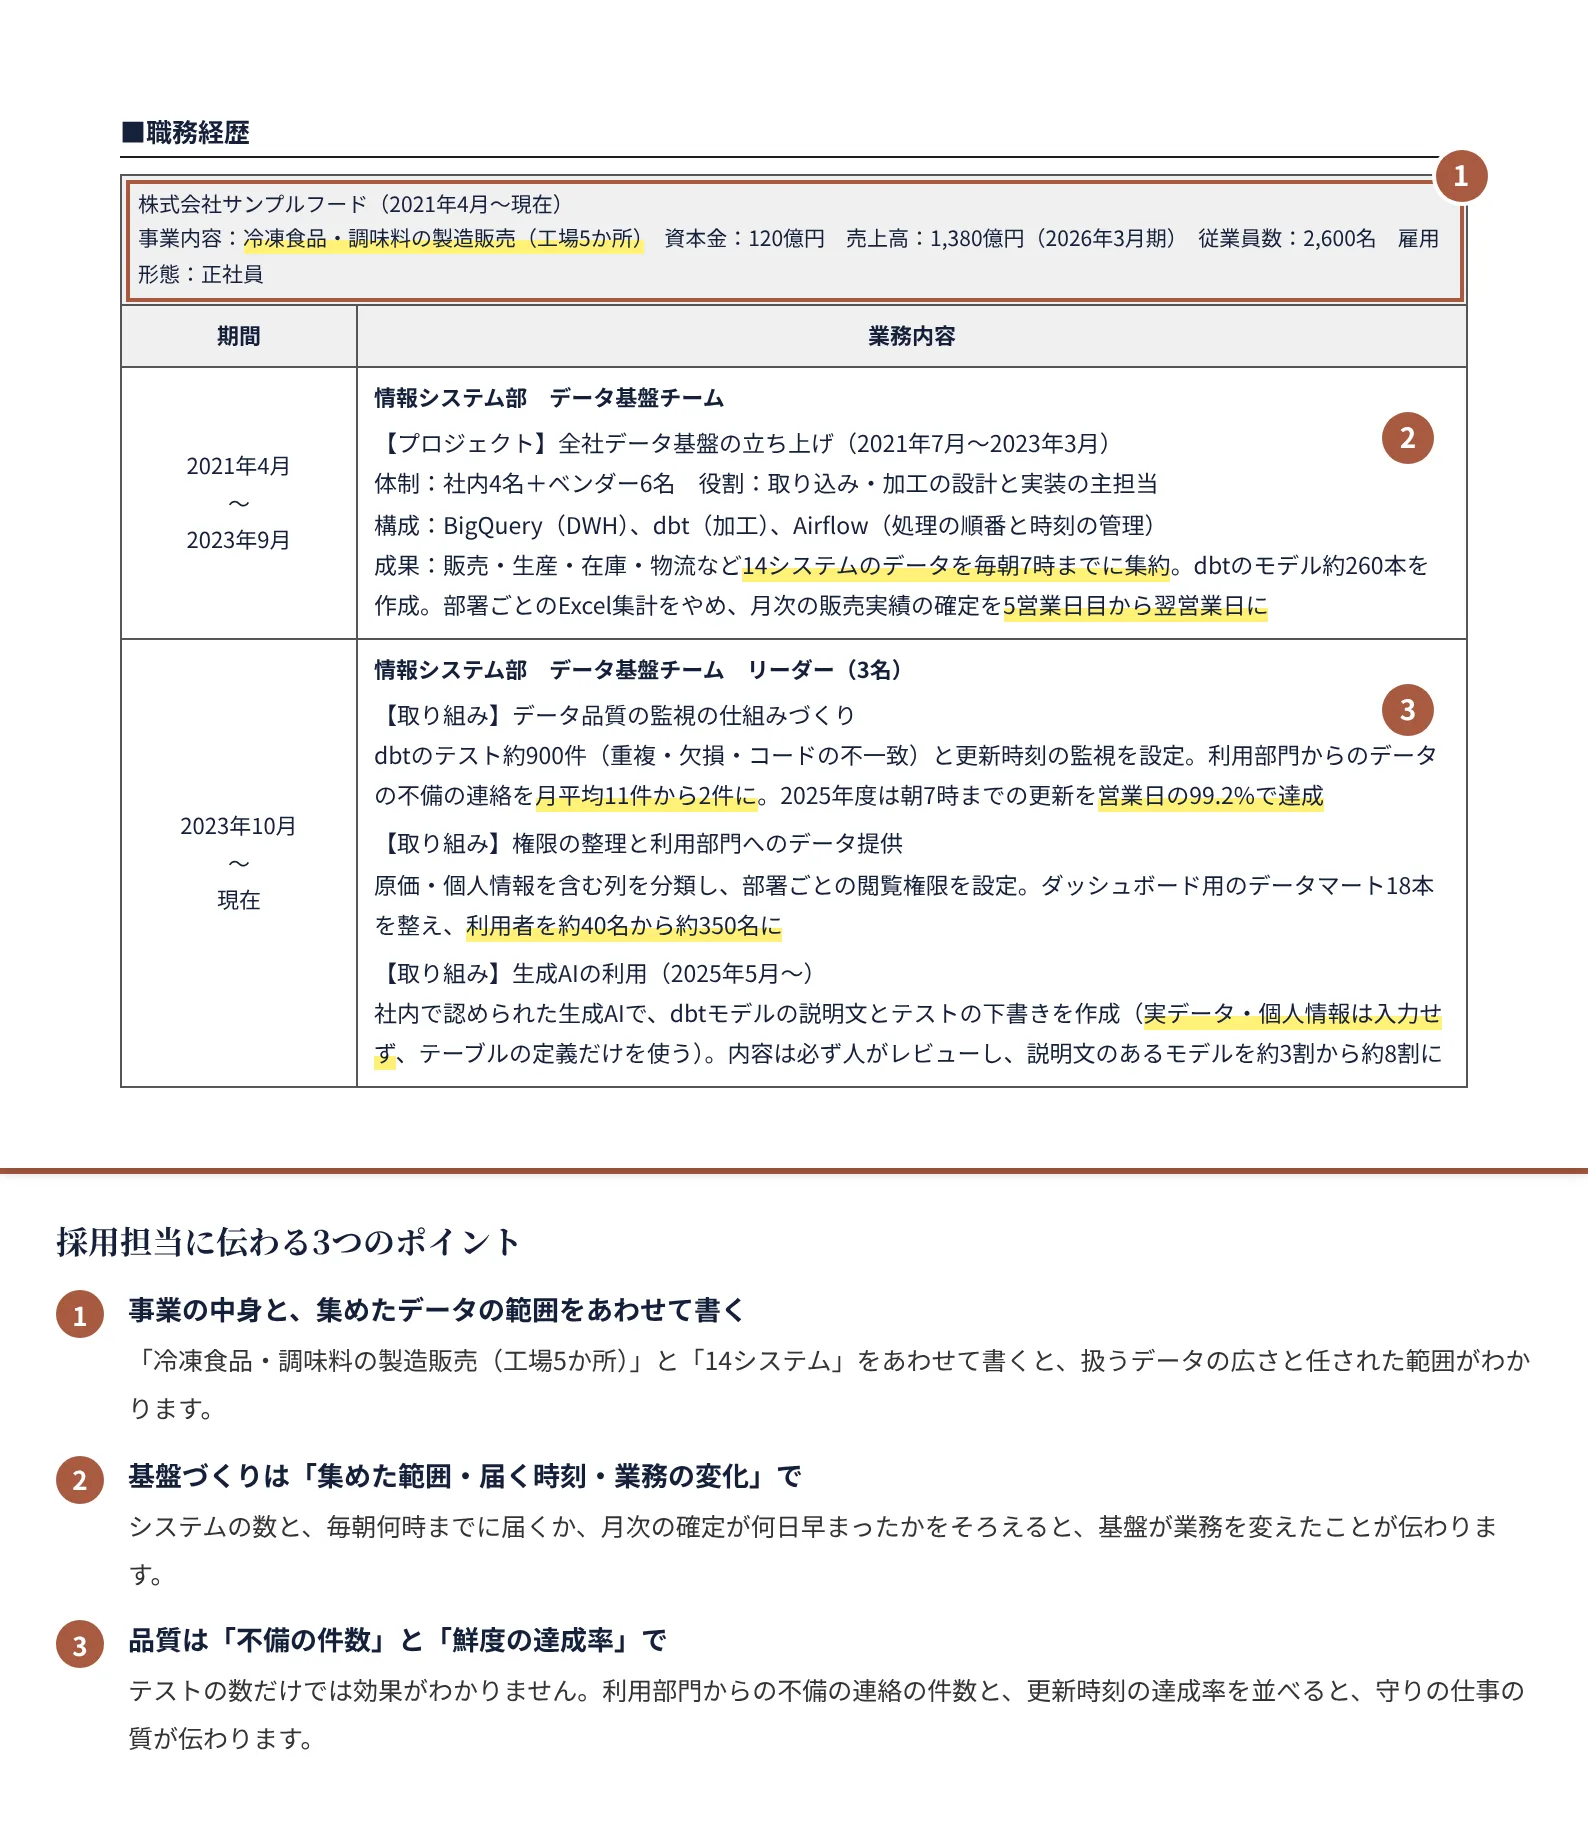
データ基盤の立ち上げは、経験の中心です。集めた範囲・届く時刻・業務の変化の3つをそろえると、基盤が会社の役に立ったことが伝わります。下の画像のポイントもあわせて確認してください。
× NG例
BigQueryを使った全社データ基盤の構築を担当しました。dbtやAirflowを使ってデータパイプラインを開発しました。
ここが惜しい
○ OK例
【プロジェクト】全社データ基盤の立ち上げ(2021年7月〜2023年3月)
体制:社内4名+ベンダー6名 役割:取り込み・加工の設計と実装の主担当
構成:BigQuery(DWH)、dbt(加工)、Airflow(処理の順番と時刻の管理)
成果:販売・生産・在庫・物流など14システムのデータを毎朝7時までに集約。dbtのモデル約260本を作成。部署ごとのExcel集計をやめ、月次の販売実績の確定を5営業日目から翌営業日に
ここが評価される
「毎朝7時まで」は、利用部門と約束した時刻です。データ基盤の価値は、データがあることより、決まった時刻に、決まった形でそろっていることにあります。dbtの「モデル」は加工の手順を書いたSQLのことで、約260本という数は基盤の大きさの目安になります。
データの章で見たとおり、ほぼ全員が欠けたデータの補完や修正をしていますが、その多くは書類に書かれません。仕組みと結果をセットで書くと、守りの仕事の質が伝わります。
× NG例
データ品質の向上に取り組みました。権限管理やデータマートの整備も担当しています。
ここが惜しい
○ OK例
【取り組み】データ品質の監視の仕組みづくり
dbtのテスト約900件(重複・欠損・コードの不一致)と更新時刻の監視を設定。利用部門からのデータの不備の連絡を月平均11件から2件に。2025年度は朝7時までの更新を営業日の99.2%で達成
【取り組み】権限の整理と利用部門へのデータ提供
原価・個人情報を含む列を分類し、部署ごとの閲覧権限を設定。ダッシュボード用のデータマート18本を整え、利用者を約40名から約350名に
ここが評価される
守ることと使えるようにすることを両方書くと、会社の大事なデータを任せられる人だと伝わります。
データエンジニアのAIの経験は、SQLやテーブルの説明文、テストの下書きに使う場面が中心です。くわしくはAIの章で解説します。
× NG例
生成AIを活用して、データ基盤の開発を効率化しました。
ここが惜しい
○ OK例
【取り組み】生成AIの利用(2025年5月〜)
社内で認められた生成AIで、dbtモデルの説明文とテストの下書きを作成(実データ・個人情報は入力せず、テーブルの定義だけを使う)。内容は必ず人がレビューし、説明文のあるモデルを約3割から約8割に
ここが評価される
ツールは名前を並べるだけでは、どこまで使えるのかが読み手に見えません。仕事の流れ(ためる・加工する・守る)に沿って分け、ツールごとに年数を書きます。
× NG例
BigQuery、dbt、Airflow、Python、SQL、GCP、ETL
ここが惜しい
○ OK例
データ基盤:BigQuery(約5年半)、Oracle Database(約3年。受託時代のDWH)
取り込み・加工:SQL・Python(8年半)、dbt(約5年)、Airflow(約5年)
品質・権限:dbtのテスト・更新時刻の監視の設計(約3年)、列・部署単位の権限設計(約3年)
ここが評価される
年数は職務経歴の期間から数えます。記入例のdbtとAirflowは、基盤の立ち上げが始まった2021年7月からです。クラウドの認定資格は有効期限があるため、「(2025年10月に更新)」のように更新した年月を添えましょう。合格済みのIPAの試験は、制度が変わってもそのまま正式名称で書きます(IPAのプレス発表)。
自己PRは「強み → 場面 → 数字」の順に書きます。データエンジニアなら、基盤を作る力と、品質を守る力の2本立てにすると、職務経歴の内容とつながります。「学ぶ姿勢」だけでは成果が見えません。
× NG例
私の強みは、新しい技術を学び続ける姿勢です。データエンジニアリングの分野は変化が速いため、常に最新のツールを勉強しています。
ここが惜しい
○ OK例
データを集め、使える形で毎朝そろえる力
14システムのデータを毎朝7時までに集約する基盤を立ち上げ、月次の販売実績の確定を5営業日目から翌営業日にしました。
ここが評価される
これまでの経歴と応募先によって、採用担当が気にすることは変わります。共通の基本は、担った範囲・自分の役割・前後の数字です。タイプごとの違いは次の表のとおりです。
| タイプ | 採用担当が見るポイント | 前に出すこと |
|---|---|---|
| 受託・SIerから事業会社のデータ基盤へ | 作って終わりにせず、長く運用し、利用部門の要望に応えられるか | 業務の変化・利用者の数・品質の仕組み |
| 事業会社から専門会社・導入支援へ | 複数の顧客や環境で通用する、技術の幅と進め方があるか | ツールの幅・基盤の規模・立ち上げの手順 |
| 分析・BIの担当からデータエンジニアへ | 分析の手前のデータを、仕組みとして整えられるか | SQL・加工の経験と、自動化した範囲 |
| アプリ・インフラのエンジニアから | データの流れと品質まで考えて作れるか | データ連携・移行・監視に関わった部分 |
記入例の人と同じ道です。事業会社では、基盤を長く運用し、利用部門の要望に応える力が求められます。採用担当は、受託で作ったジョブの数より、顧客の業務がどう変わったかを書ける人かを見ています。
職務経歴書に書きたいこと
記入例
【プロジェクト】ドラッグストアチェーンの売上データ連携(2019年4月〜2020年9月)
規模:8名 役割:ETL開発の担当(Python・SQL。DWHはOracle Database)
成果:POS・EC・会員など6システムから日次で取り込むジョブ約120本を開発。再実行の手順を整え、異常終了からの復旧を平均約3時間から約40分に
ポイント
よくある落とし穴は、受託の案件を全部同じ分量で並べるケースです。応募先に近い案件を詳しく書き、ほかは1〜2行にしましょう。
専門会社や導入支援では、さまざまな顧客の環境で、短い期間で基盤を立ち上げる力が求められます。採用担当は、技術の幅と立ち上げの進め方を見ています。
職務経歴書に書きたいこと
記入例
※記入例とは別の架空例です
【取り組み】基盤の立ち上げ手順の標準化(2024年4月〜2025年3月)
データを集める順番を「利用部門の要望が多い順」に決め、取り込み・テスト・説明文の書き方を標準の手順にまとめた。新しいシステムの追加にかかる期間を平均約6週間から約3週間に
ポイント
よくある落とし穴は、自社の業務の話が中心になり、技術が薄くなるケースです。ツール・構成・手順を厚く書きましょう。
自分の経歴に合わせた下書きを、AIで作れます
分析やBI(ダッシュボードづくり)の担当者は、データの近くで働いた経験を活かせます。採用担当は、手で整えていたデータを仕組みとして毎日整える側に回れるかを見ています。
職務経歴書に書きたいこと
記入例
※記入例とは別の架空例です
【取り組み】週次の売上レポートの自動化(2024年10月〜2025年6月)
手作業で集めていた5つのデータを、SQLとスケジュール実行で毎朝自動で集計する形に変更。作成にかかる時間を週約8時間から約1時間に
ポイント
よくある落とし穴は、分析で得た示唆ばかり書くケースです。分析の手前でデータをどう整えたかを中心に書きましょう。
アプリやインフラのエンジニアは、プログラムやクラウドの経験を活かせます。これまでの仕事から、データに関わった部分を切り出して書きましょう。
職務経歴書に書きたいこと
記入例
※記入例とは別の架空例です
【プロジェクト】受注データの連携の作り直し(2023年4月〜2024年3月)
役割:バックエンドの開発担当(Python)
成果:受注システムから会計システムへの連携を1日1回から1時間ごとに変更。件数の照合を自動で行い、手作業での突き合わせを月約20時間からほぼ0に
ポイント
よくある落とし穴は、言語やフレームワークの経験が中心になり、データの経験が埋もれるケースです。
無料テンプレート
書き方がわかったら、テンプレートに書き込んでみましょう
この記事の記入例と同じ形式の、空欄のテンプレートと記入見本のセットです。Word・Excel・PDFから選べます。
データエンジニアのAIの経験は、自分の作業でAIを使った経験と、AIが使うデータを整えた経験に分けて書くと整理しやすくなります。社内ルールで使えなかった人も、書けることがあります。立場ごとに書くことは次のとおりです。
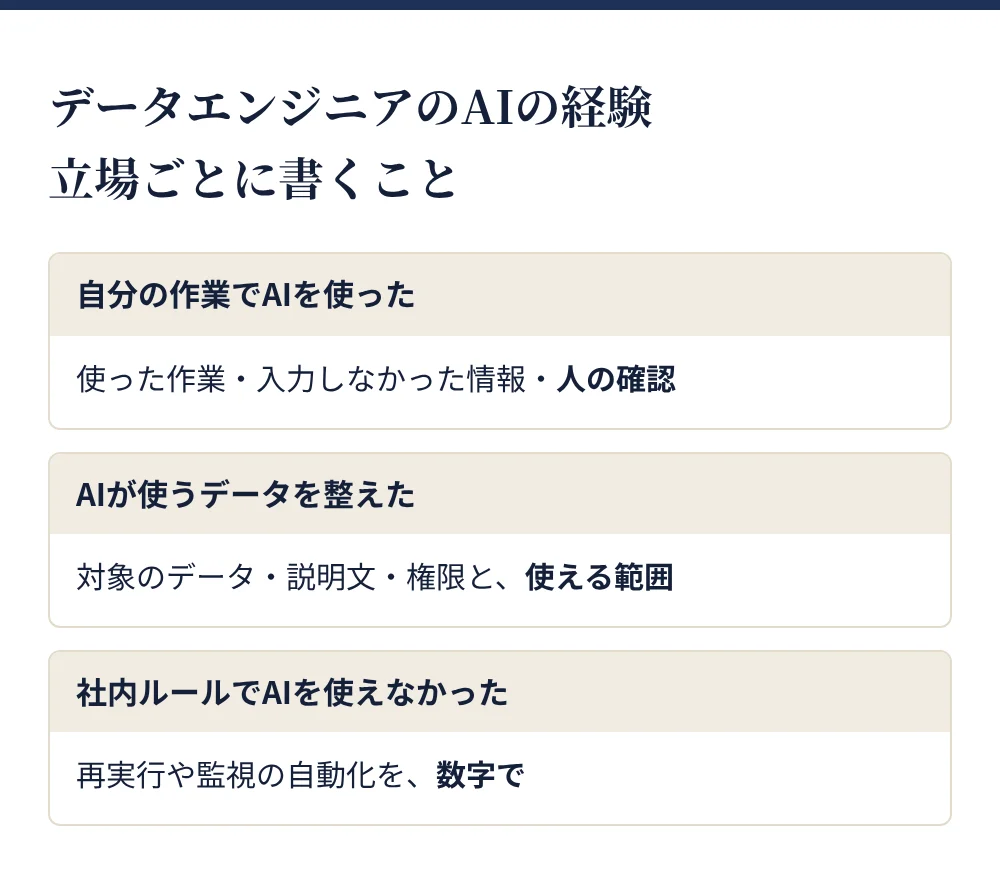
AIの使い方や、AIの経験を求める度合いは、応募先によって大きく違います。IPAの「DX動向2026」プレス発表では、AIを導入している企業は従業員1,001人以上で8割近くにのぼる一方、101人以下では16.6%でした。
AIを使った経験がないからといって、不利になると考える必要はありません。求人票に「生成AI」「AI活用」などの言葉があれば具体的に書き、なければ1行添える程度で十分です。
総務省の「令和8年版 情報通信白書」によると、日本で生成AIを一つ以上の業務で使っている企業は86.4%でした(活用方針を「わからない」と答えた企業を除く)。「デジタルスキル標準 ver.2.0」も、AIの活用が広がる中でデータの整備を担う役割が重要になったことを、見直しの理由に挙げています。
編集部の読みでは、データエンジニアのAIの経験は「AIを使った」ことより、「AIが正しく使えるデータを用意した」ことの方が、職種の強みになります。元のデータに欠けや古い値があれば、AIはそれをもとに答えてしまうからです。
2026年時点で、AIが関わる場面は次のとおりです。どの場面でも、AIに任せるのは「案」や「下書き」までで、本番で動かすかは人が判断します。
| 関わり方 | 具体例 | 人が確かめること |
|---|---|---|
| 説明文・テストの下書き | テーブルや列の説明文、dbtのテストの候補を作る(記入例の使い方) | 説明が業務の意味と合っているか、テストが足りているか |
| SQL・加工の手順の下書き | 集計のSQLや加工の手順のたたき台を作る | 結果の件数と合計が元のデータと合うか |
| 処理の流れづくりの補助 | クラウドのAIエージェントで、言葉の指示から処理の流れの案を作る | 実行前に計画と中身を確かめる |
| AIが使うデータの整備 | 社内のAIに使わせてよいテーブルを選び、説明文と権限を整える | 見せてよいデータだけが使われているか |
Google Cloudの公式ドキュメントも、言葉の指示でBigQueryの処理の流れを作れるAIエージェント(Data Engineering Agent)について、そのAIエージェントは処理を実行できず、人が確かめて実行する必要があると説明しています。
加工の手順が1行違うだけで、毎日の数字がずれ続けます。そのため、AIの案を本番の処理に組み込む前に何を確かめたかまで書いておくと、採用担当は安心して基盤を任せられる人かを判断できます。
項目別の書き方で紹介した記入例の「生成AIの利用」は、使った作業(説明文・テスト)・入力しなかった情報(実データ・個人情報)・確かめ方(人のレビュー)・効果(約3割→約8割)の4つがそろっています。
効果の数字は、AIを使う前と後で同じ基準で測ったものだけを書きます。測っていなければ数字を作らず、使った作業と確かめ方だけを書きましょう。例:「集計SQLの下書きに社内の生成AIを利用(テーブルの定義だけを入力)。結果は元データの件数・合計と照合してから反映」
書く場所は、職務経歴の取り組みに1つと、テクニカルスキル欄に1行が目安です。記入例もこの2か所に書いています。
社内のデータを使って答えるAIの仕組みに関わった人は、対象のデータ・説明文・権限の3つを押さえて書きましょう。列の説明文があると、AIも人も列の意味を取り違えにくくなります。権限は、人が画面で見るときと同じ線引きを、AIの答えにも当てはめます。
記入例
※記入例とは別の架空例です
【プロジェクト】社内向けの売上問い合わせAIのデータ整備(2025年11月〜2026年6月)
役割:データの選定・説明文・権限の設計(社内3名)
成果:AIに使わせるテーブルを42本に絞り、全列に説明文を付与。部署ごとの閲覧権限をAIの回答にも反映し、権限外のデータを使った回答は検証の300問で0件
ポイント
個人情報や原価を扱う職場では、ルールで生成AIを使えないこともあります。ルールに従ってデータを守ってきたこと自体が大切な姿勢です。代わりに、ジョブの再実行や遅れの通知を自動化した経験を数字で書きましょう。AIの記載がある求人なら、面接で「使えるなら、どの作業から試したいか」を話せるようにしておくと安心です。
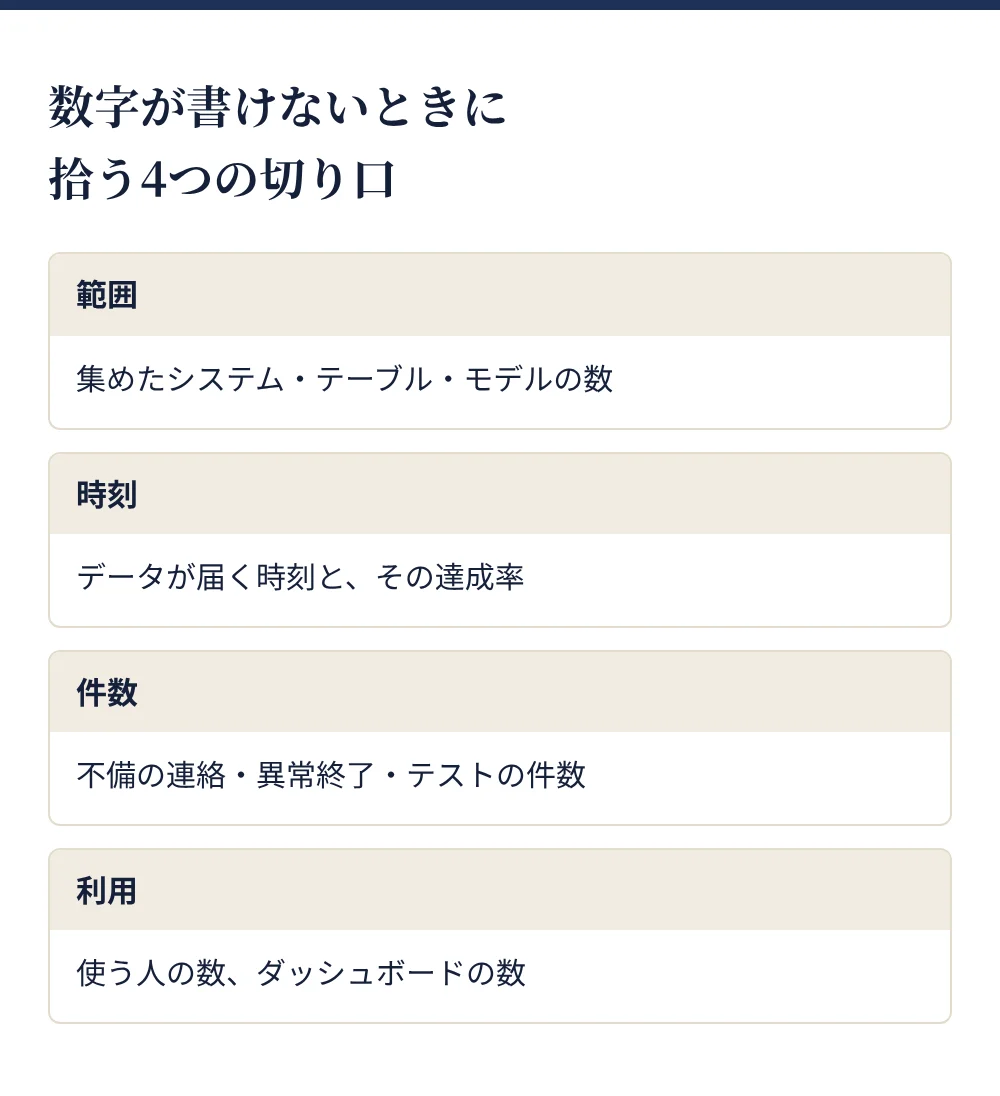
データエンジニアの成果は「毎日きちんとデータがそろった」という形になりやすく、数字が見つけにくい仕事です。範囲・時刻・件数・利用の4つの切り口で探しましょう。
運用が中心で、目立った成果がない
まずは範囲を書きます。例:「14システムのデータを毎朝7時までに集約」「dbtのモデル約260本」集めたシステムやテーブルの数は、任された範囲の大きさを示す数字です。
効果を測っていなかった
時刻と達成率を探します。例:「朝7時までの更新を営業日の99.2%で達成」処理の管理ツールに終了時刻の記録が残っていれば、あとから数えられます。
品質の改善を数字にできない
利用部門からの問い合わせや連絡の件数を数えます。例:「データの不備の連絡を月平均11件から2件に」チャットや問い合わせの記録から、前後の数をさかのぼれることがあります。
顧客名やデータの量を社外に出せない
業種とシステムの数で書きます。例:「ドラッグストアチェーンの売上データ連携」「6システムから日次で取り込む」顧客名・構成・セキュリティの設定は書かず、外に出しても問題のない数字を選びましょう。
無料テンプレート
記入見本を横に置くと、書き進めやすくなります
見本と見比べながら空欄を埋めていけば、ここまでの書き方をそのまま当てはめられます。
書き終えたら、提出前に次の7つを確認しましょう。
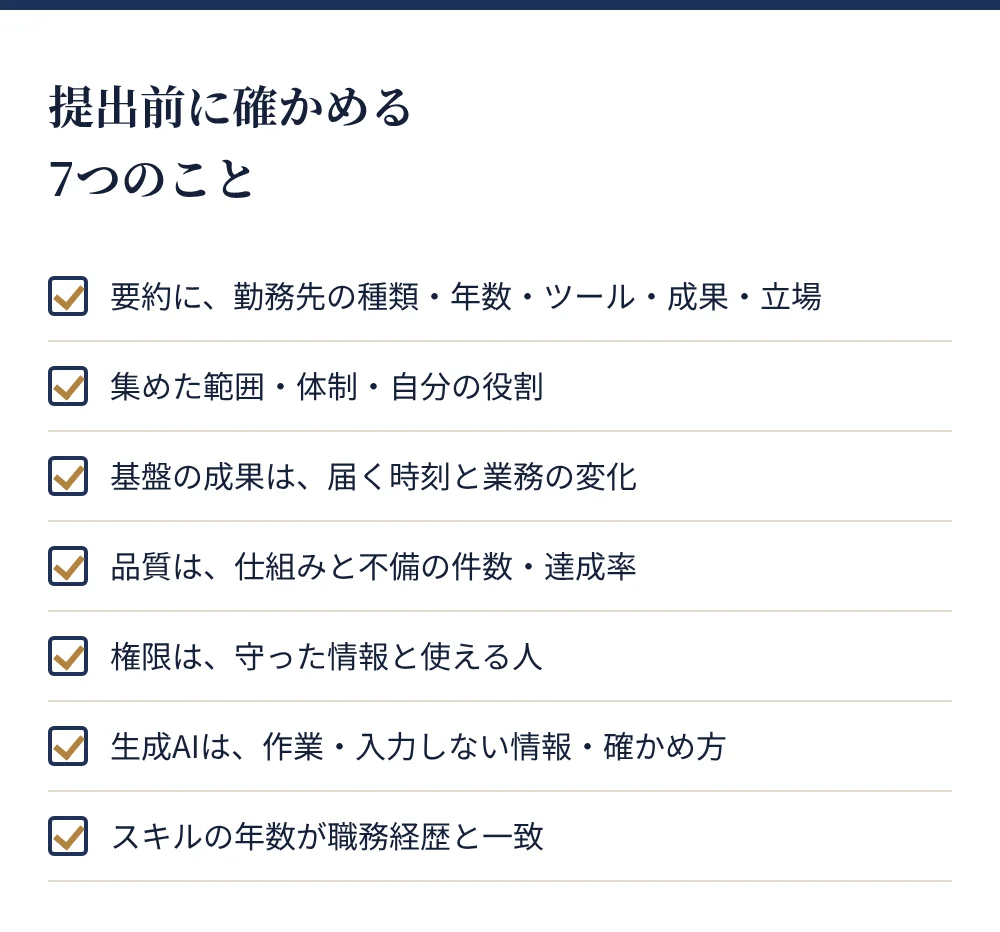
最後に、要約・職務経歴・自己PRで同じ数字を使う箇所を読み合わせ、食い違いがないかを確かめましょう。
データエンジニアに応募するなら、分析の結果より、元になるデータをどう集め、整え、使える状態にしたかを中心に書きます。分析の経験は、利用者の立場がわかる強みとして1〜2行添えましょう。
顧客名は業種に置きかえ、システムの数・ジョブの数・復旧の時間など、外に出しても問題のない数字で書けば十分です。
役割が同じなら経験は活かせます。「DWH」「加工」「処理の管理」のように役割で分類し、使ったツールと年数を書きましょう。
必須ではありません。持っている場合は、取得年月・正式名称・更新した年月を書きましょう。IPAの情報処理技術者試験は2027年度から新しい制度に移り、「データマネジメント試験(仮称)」も新設される予定です(2026年3月時点の案)。これから受ける人は、IPAのページで最新の区分を確かめましょう。
経験がないことだけで不利になるとは限りません。求人票にAIの記載がなければ、無理に書く必要はありません。記載のある求人では、ジョブの再実行や更新の監視の自動化など、手作業を減らした経験を数字で書きましょう。データの説明文や権限を整えた経験も材料になります。
この記事の記入例テンプレートを無料でダウンロード
Word・Excel・PDFの3形式に対応。空欄テンプレートと記入見本のセットです。
参考資料